[DE Blog #36] Bản Chất Động Cơ Lưu Trữ Dữ Liệu Phân Tán (Storage Engine Internals): So Sánh Chuyên Sâu B-Tree vs. LSM-Tree, MemTable, WAL, SSTables, Bloom Filters & Thuật Toán Compaction
1. Bối cảnh thực tế (Context & Problem Statement)
Khi tối ưu hóa cơ sở dữ liệu ở quy mô hàng trăm Terabyte đến Petabyte, mọi lý thuyết trừu tượng đều phải đối mặt với một giới hạn vật lý khắc nghiệt của phần cứng:
- Random Disk I/O (Đọc/Ghi ngẫu nhiên): Rất chậm và tốn kém tài nguyên (ngay cả trên ổ cứng NVMe SSD hiện đại, Random Write vẫn gây suy giảm tuổi thọ đĩa do hiện tượng ghi khuếch đại ở tầng flash - Flash Wear-out).
- Sequential Disk I/O (Đọc/Ghi tuần tự): Nhanh hơn từ đến vì tận dụng được cơ chế nạp đệm luồng liên tục của hệ điều hành.
Các cơ sở dữ liệu quan hệ truyền thống (PostgreSQL, MySQL InnoDB) sử dụng cấu trúc B-Tree / B+ Tree. B-Tree cập nhật dữ liệu trực tiếp tại chỗ (In-Place Updates), dẫn đến việc phải liên tục thực hiện các thao tác ghi ngẫu nhiên trên các trang đĩa (Disk Pages) và chia tách trang (Page Splits). Khi lưu lượng ghi tăng lên hàng trăm nghìn giao dịch mỗi giây (), B-Tree nhanh chóng bị nghẽn cổ chai.
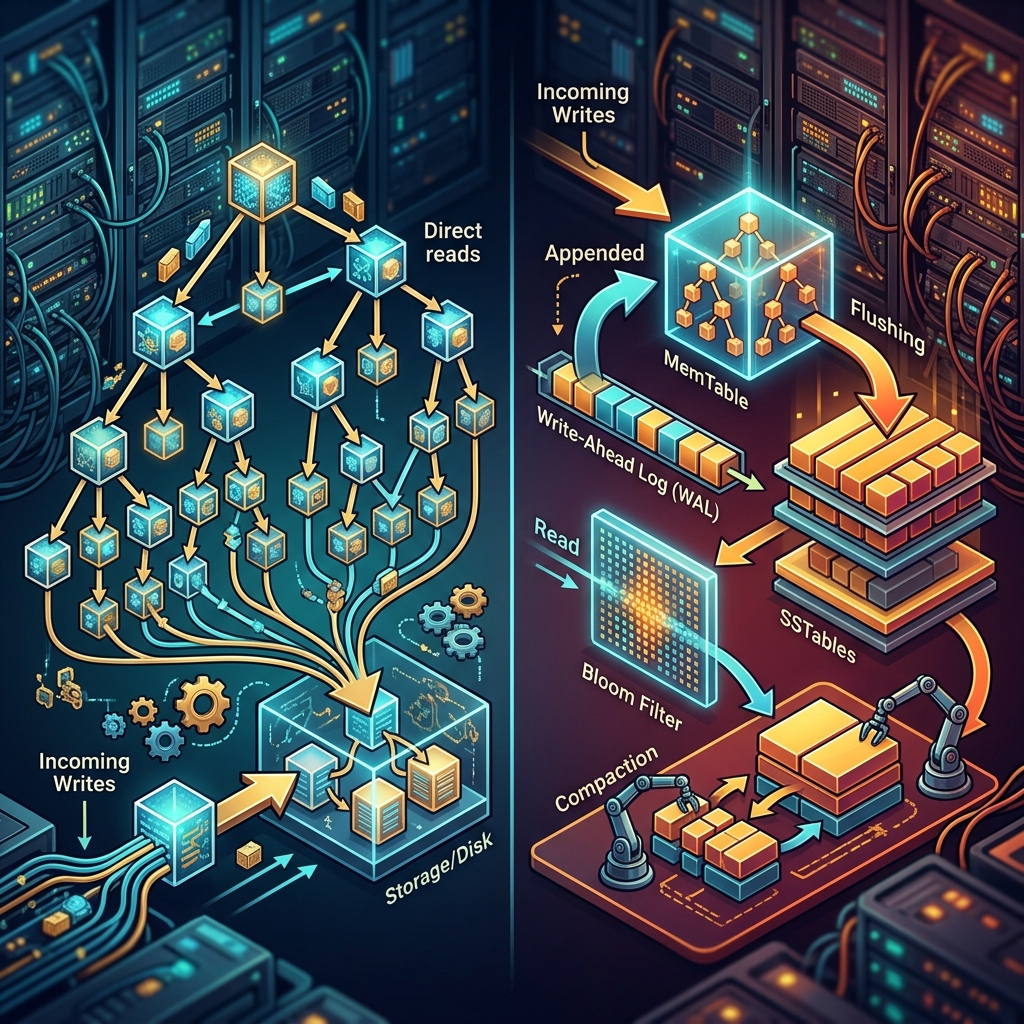
Để giải quyết bài toán ghi nạp dữ liệu lớn thời gian thực, toàn bộ thế hệ Big Data hiện đại (Apache Cassandra, RocksDB, ScyllaDB, TiKV, ClickHouse MergeTree) đều chuyển sang sử dụng kiến trúc LSM-Tree (Log-Structured Merge-Tree): Biến mọi thao tác ghi thành ghi tuần tự liên tục (Append-Only).
2. Các Khái Niệm & Cơ Chế Cốt Lõi
2.1. Vòng Đời Dữ Liệu Trong LSM-Tree: Write Path & Read Path
WRITE PATH (Tốc độ tối đa O(1) - Zero Random I/O):
[Ghi dữ liệu mới (Key, Value)]
         |
         +---> (1) Ghi tuần tự vào đĩa: [Write-Ahead Log (WAL)] (Đảm bảo an toàn khi sập nguồn)
         |
         +---> (2) Chèn vào RAM: [MemTable (SkipList)] (Sắp xếp theo thứ tự Key)
                                       |
                                       v (Khi MemTable đầy 64MB)
                        [Immutable MemTable] (Chờ xả xuống đĩa)
                                       |
                                       v (Flush tuần tự ra đĩa SSD)
                        [SSTables (Sorted String Tables) trên Đĩa]
-
Write Path (Đường đi của luồng Ghi):
- Khi có thao tác
PUT(key, value)hoặcDELETE(key)(thao tác xóa thực chất là ghi một bản ghi đặc biệt gọi là Tombstone): - Dữ liệu được ghi nối tiếp vào Write-Ahead Log (WAL) trên đĩa để đảm bảo tính bền bỉ (Durability).
- Đồng thời, dữ liệu được chèn vào MemTable trên bộ nhớ RAM (được cài đặt bằng cấu trúc dữ liệu SkipList hoặc Cây Đỏ-Đen Red-Black Tree để luôn duy trì các khóa theo thứ tự tăng dần).
- Thao tác ghi hoàn tất ngay tại đây trong vòng vài micro-giây!
- Khi MemTable đạt kích thước quy định (ví dụ ), nó chuyển thành Immutable MemTable và một tiến trình nền bất đồng bộ sẽ xả (Flush) toàn bộ dữ liệu tuần tự xuống đĩa thành một file SSTable (Sorted String Table) mới.
- Khi có thao tác
-
Read Path (Đường đi của luồng Đọc):
- Do dữ liệu được ghi thành nhiều file SSTable riêng biệt theo thời gian, khi đọc
GET(key), hệ thống phải kiểm tra theo thứ tự từ mới nhất đến cũ nhất: - Để tránh việc phải đọc từng file SSTable trên đĩa (gây nghẽn đọc), LSM-Tree bắt buộc phải sử dụng Bloom Filters.
- Do dữ liệu được ghi thành nhiều file SSTable riêng biệt theo thời gian, khi đọc
READ PATH (Với sự hỗ trợ của Bloom Filter & Block Cache):
[Truy vấn GET(key)]
         |
         v
[1. Kiểm tra MemTable trong RAM] ---> (Thấy key? -> Trả về kết quả ngay!)
         | (Không thấy)
         v
[2. Kiểm tra Bloom Filter của từng SSTable]
         |
         +---> [Bloom Filter trả về: "CHẮC CHẮN KHÔNG CÓ"] ---> BỎ QUA FILE SSTABLE ĐÓ!
         |
         +---> [Bloom Filter trả về: "CÓ THỂ CÓ"]
                     |
                     v
               [3. Đọc Index Block & Data Block của SSTable từ Đĩa SSD]
2.2. Cấu Trúc Xác Suất Bloom Filter (Vũ Khí Triệt Tiêu I/O Đọc)
Bloom Filter là một cấu trúc dữ liệu xác suất tiết kiệm bộ nhớ cực đại, dùng để trả lời câu hỏi: "Khóa này có tồn tại trong file SSTable hay không?"
- Cấu trúc: Một mảng bit kích thước (toàn bộ khởi tạo bằng ) và hàm băm độc lập ().
- Thao tác Thêm Khóa ():
- Tính giá trị băm: .
- Bật các bit tại các vị trí đó lên giá trị
1.
- Thao tác Kiểm tra ():
- Kiểm tra toàn bộ vị trí bit tương ứng.
- Nếu có ít nhất 1 bit bằng
0: Khẳng định Khóa CHẮC CHẮN KHÔNG TỒN TẠI trong file SSTable Không cần đọc đĩa! (Zero False Negatives). - Nếu tất cả các bit đều bằng
1: Khóa CÓ THỂ TỒN TẠI (với xác suất dương tính giả nhỏ - False Positive Rate ). Lúc này hệ thống mới thực sự đọc đĩa.
Mảng Bit (m = 10):  [ 0 | 1 | 0 | 1 | 0 | 0 | 1 | 0 | 1 | 0 ]
                           ^       ^           ^       ^
                           |       |           |       |
                 h1("user_1")=1   h2("user_1")=3   h3("user_1")=6
2.3. Các Chiến Lược Gộp Dữ Liệu (Compaction Strategies)
Theo thời gian, số lượng file SSTable trên đĩa sẽ tăng lên, dẫn đến việc có nhiều bản ghi trùng lặp, nhiều rác Tombstone và làm chậm tốc độ đọc. Compaction là tiến trình nền gộp các file SSTable nhỏ thành các file lớn hơn, loại bỏ dữ liệu cũ và sắp xếp lại dữ liệu.
- Size-Tiered Compaction Strategy (STCS - Chuẩn của Cassandra):
- Gom các file SSTable có kích thước tương đương nhau lại để gộp thành 1 file lớn hơn.
- Ưu điểm: Tốc độ ghi cực nhanh, tốn ít tài nguyên CPU.
- Nhược điểm: Khuếch đại không gian (Space Amplification) rất cao (Cần dự trữ tới dung lượng đĩa trống để thực hiện compaction).
- Leveled Compaction Strategy (LCS - Chuẩn của RocksDB / ScyllaDB):
- Chia đĩa thành nhiều tầng (Level 0, Level 1, Level 2... mỗi tầng có dung lượng gấp 10 lần tầng trước: ).
- Từ Level 1 trở đi, các dải khóa (Key Ranges) giữa các SSTable trong cùng 1 Level hoàn toàn không bị chồng chéo nhau (Non-overlapping).
- Ưu điểm: Tốc độ đọc siêu nhanh (chỉ cần kiểm tra tối đa 1 file SSTable trên mỗi Level), tiết kiệm dung lượng đĩa ( overhead).
- Nhược điểm: Chi phí ghi khuếch đại (Write Amplification) cao hơn do phải gộp liên tục.
- Time-Window Compaction Strategy (TWCS - Dành riêng cho Time-Series):
- Gom các SSTable theo từng khung thời gian cố định (ví dụ theo từng ngày). Sau khi cửa sổ thời gian trôi qua, các file này không bao giờ bị xáo trộn lại, tự động xóa sạch khi hết hạn TTL.
2.4. Tam Giác Đánh Đổi RUM (The RUM Conjecture in Storage Engines)
Mọi động cơ lưu trữ đều phải đánh đổi giữa 3 yếu tố:
- Write Amplification (WA): Số lượng bytes thực tế ghi xuống đĩa so với số bytes của dữ liệu gốc ().
- Read Amplification (RA): Số lượng bytes đĩa cần đọc để phục vụ một truy vấn đơn lẻ.
- Space Amplification (SA): Tỷ lệ dung lượng đĩa bị chiếm dụng bởi dữ liệu rác/trùng lặp so với dung lượng dữ liệu hữu ích thực tế.
3. Các Bảng Markdown So Sánh Chi Tiết
📊 Bảng 1: So Sánh Toàn Diện: B-Tree vs. LSM-Tree Storage Engines
| Tiêu chí kỹ thuật | B-Tree / B+ Tree Storage Engine | LSM-Tree (Log-Structured Merge-Tree) |
|---|---|---|
| Cơ chế cập nhật dữ liệu | In-Place Updates (Ghi đè trực tiếp lên Page đĩa) | Append-Only (Luôn ghi tuần tự vào đuôi, không ghi đè) |
| Bản chất Disk I/O khi Ghi | Random I/O (Gây nghẽn đĩa và phân mảnh trang) | Sequential I/O (Tối ưu hóa phần cứng tuyệt đối) |
| Tốc độ Ghi (Write Throughput) | Trung bình ( writes/s) | Cực cao ( writes/s) |
| Tốc độ Đọc (Point Lookup) | Nhanh và ổn định (Chỉ cần duyệt cây B-Tree ) | Phụ thuộc vào Bloom Filter và số tầng Level |
| Khuếch đại Ghi (Write Amp - WA) | Thấp/Trung bình | Cao hơn (Do tiến trình Compaction ghi lại nhiều lần) |
| Khuếch đại Không gian (Space Amp) | Cao do phân mảnh trang (Page Fragmentation ) | Rất thấp (Dữ liệu được nén chặt và liên tục sau Compaction) |
| Cơ sở dữ liệu tiêu biểu | PostgreSQL, MySQL (InnoDB), SQLite, Oracle | RocksDB, Apache Cassandra, ScyllaDB, ClickHouse, TiKV |
📊 Bảng 2: So Sánh Các Chiến Lược Compaction Trong LSM-Tree
| Tiêu chí | Size-Tiered Compaction (STCS) | Leveled Compaction (LCS) | Time-Window Compaction (TWCS) |
|---|---|---|---|
| Tối ưu hóa cho khối lượng | Ghi cực nhiều (Write-Heavy) | Đọc nhiều hoặc Cân bằng (Read-Heavy / General) | Chuỗi thời gian (Time-Series Data) |
| Dung lượng đĩa dự phòng yêu cầu | Rất cao (Cần tới đĩa trống) | Rất thấp ( đĩa trống) | Thấp |
| Tốc độ đọc (Read Performance) | Chậm hơn (Key có thể nằm ở nhiều SSTable) | Rất nhanh (Key chỉ nằm ở tối đa 1 SSTable/Level) | Nhanh khi truy vấn theo mốc thời gian |
| Write Amplification | Thấp () | Cao () | Thấp nhất () |
| Cơ sở dữ liệu áp dụng | Apache Cassandra mặc định | RocksDB, ScyllaDB, LevelDB, CockroachDB | InfluxDB, Cassandra Time-Series tables |
📊 Bảng 3: So Sánh Động Cơ Lưu Trữ Của Các Hệ Quản Trị Dữ Liệu Lớn Hiện Đại
| Hệ thống | Storage Engine bên dưới | Cấu trúc dữ liệu chính | Cơ chế xử lý Dữ liệu Xóa / Cập nhật |
|---|---|---|---|
| RocksDB | Embedded LSM-Tree (C++ Native) | MemTable (SkipList) + Block-based SSTables (LCS) | Ghi nhận Tombstone Dọn sạch tại Compaction |
| Apache Cassandra | Distributed LSM-Tree on JVM | MemTable + SSTables (STCS / LCS) | Ghi nhận Tombstone kèm TTL Gộp SSTables |
| ClickHouse | MergeTree Engine | Columnar Parts trên đĩa (Sorted by Primary Key) | Ghi Part mới Background Merge Parts bất đồng bộ |
| PostgreSQL | Heap Files + B+ Tree Indexes | 8KB Disk Pages có WAL (Write-Ahead Logging) | Đánh dấu dead tuple Cần tiến trình VACUUM dọn dẹp |
4. Best Practices & Tinh Chỉnh Hiệu Năng LSM-Tree Thực Chiến (Pro-Tips)
💡 Khắc Phục Hiện Tượng "Write Stall" Trong RocksDB / Cassandra
- Write Stall là gì? Khi tốc độ nạp dữ liệu từ ứng dụng quá nhanh vượt quá năng lực dọn dẹp của tiến trình Compaction dưới đĩa. Bộ đệm MemTable bị đầy tràn nhưng không thể Flush xuống Level 0 (do Level 0 có quá nhiều file đang chờ Compaction) Engine tự động khóa cứng hoặc làm chậm toàn bộ các thao tác ghi mới!
- Chiến lược khắc phục (Tuning parameters):
- Tăng số lượng luồng chạy Compaction nền:
max_background_compactions = 8hoặcmax_background_jobs = 12. - Tăng số lượng file tối đa cho phép ở Level 0 trước khi bắt đầu Stall: Tăng
level0_slowdown_writes_trigger(ví dụ từ 20 lên 40) vàlevel0_stop_writes_trigger(từ 36 lên 64). - Cấp phát vùng nhớ đệm Write Buffer Manager hợp lý để chia sẻ hạn mức RAM giữa các Column Families.
- Tăng số lượng luồng chạy Compaction nền:
💡 Tối Ưu Hóa Kích Thước Bloom Filter (Bits Per Key)
- Mặc định, cấu hình mang lại tỷ lệ dương tính giả (False Positive Rate) .
- Nếu ứng dụng có tỷ lệ đọc trượt (Read Misses) rất cao (tìm kiếm các khóa không tồn tại), tăng lên sẽ giảm False Positive Rate xuống còn , giúp giảm số lần phải đọc ổ đĩa SSD vô ích!
5. Góc Ôn Luyện Phỏng Vấn (Interview Corner)
❓ Câu hỏi 1: Giải thích chi tiết đường đi của dữ liệu khi Ghi (Write Path) và khi Đọc (Read Path) trong một LSM-Tree Storage Engine (như RocksDB). Tại sao LSM-Tree lại có thông lượng ghi (Write Throughput) cao hơn B-Tree từ 10 đến 50 lần?
- Gợi ý trả lời:
- Quy trình Write Path:
- Khi nhận lệnh
PUT(K, V), dữ liệu được ghi tuần tự vào file WAL trên đĩa (Append-only để chống mất dữ liệu khi crash). - Dữ liệu được chèn ngay vào cấu trúc dữ liệu trên RAM là MemTable (được giữ theo thứ tự sắp xếp bằng SkipList).
- Thao tác ghi hoàn tất lập tức mà hoàn toàn không có bất kỳ thao tác Random I/O nào trên đĩa.
- Khi MemTable đầy, nó được xả tuần tự (Sequential Flush) xuống đĩa thành file SSTable bất biến (Immutable).
- Khi nhận lệnh
- Quy trình Read Path:
- Tìm kiếm trên MemTable hiện tại trong RAM Tìm trên các Immutable MemTables trong RAM.
- Nếu không thấy, duyệt qua các tầng SSTables trên đĩa. Tại mỗi file SSTable, hệ thống kiểm tra Bloom Filter trong RAM: Nếu Bloom Filter báo không có, bỏ qua file ngay lập tức; nếu báo có thể có, hệ thống kiểm tra Block Cache và đọc đúng khối dữ liệu chứa Key đó.
- Lý do thông lượng ghi vượt trội B-Tree:
- B-Tree bắt buộc phải tìm đúng trang đĩa chứa khóa để sửa trực tiếp (In-Place Update). Việc này đòi hỏi nhiều lần đọc/ghi ngẫu nhiên (Random Disk I/O) và kích hoạt chia tách trang (Page Splits) tốn kém.
- LSM-Tree gom toàn bộ các thao tác ghi ngẫu nhiên trên RAM thành 1 thao tác ghi tuần tự duy nhất với tốc độ tối đa của phần cứng đĩa SSD.
- Quy trình Write Path:
❓ Câu hỏi 2: Bloom Filter hoạt động dựa trên nguyên lý xác suất nào? Tại sao Bloom Filter không bao giờ có False Negative (Âm tính giả) nhưng lại có thể có False Positive (Dương tính giả)?
- Gợi ý trả lời:
- Nguyên lý cấu tạo: Bloom Filter gồm một mảng bit (khởi tạo toàn ) và hàm băm độc lập. Khi thêm phần tử , ta băm qua hàm và bật tất cả các bit tại các vị trí đó lên
1. - Tại sao không bao giờ có False Negative (Không bao giờ bỏ sót nếu có):
- Nếu một khóa thực sự đã được thêm vào trước đó, thì chắc chắn tất cả vị trí bit tương ứng của nó đã được bật lên
1. - Do đó, nếu khi kiểm tra mà ta phát hiện dù chỉ 1 bit duy nhất tại các vị trí đó mang giá trị
0, ta có thể khẳng định chắc chắn rằng khóa chưa từng được thêm vào Zero False Negatives.
- Nếu một khóa thực sự đã được thêm vào trước đó, thì chắc chắn tất cả vị trí bit tương ứng của nó đã được bật lên
- Tại sao có thể xảy ra False Positive (Báo có nhưng thực ra không có):
- Do kích thước mảng bit là hữu hạn, khi thêm hàng triệu phần tử khác nhau (), các bit tại các vị trí của khóa vô tình bị các phần tử khác bật lên
1(hiện tượng xung đột mã băm - Hash Collisions). - Khi kiểm tra phần tử (dù chưa từng được thêm), hệ thống thấy tất cả bit đều đã bằng
1do các phần tử khác bật giùm Kết luận nhầm là có thể tồn tại (False Positive).
- Do kích thước mảng bit là hữu hạn, khi thêm hàng triệu phần tử khác nhau (), các bit tại các vị trí của khóa vô tình bị các phần tử khác bật lên
- Nguyên lý cấu tạo: Bloom Filter gồm một mảng bit (khởi tạo toàn ) và hàm băm độc lập. Khi thêm phần tử , ta băm qua hàm và bật tất cả các bit tại các vị trí đó lên
❓ Câu hỏi 3: So sánh Size-Tiered Compaction Strategy (STCS) và Leveled Compaction Strategy (LCS). Trong trường hợp nào bạn bắt buộc phải chuyển cấu hình Cassandra / RocksDB từ STCS sang LCS?
- Gợi ý trả lời:
- So sánh cốt lõi:
- STCS (Size-Tiered): Gom các file SSTable có kích cỡ bằng nhau lại để gộp thành file lớn hơn. Các file này có thể chứa dải khóa trùng lặp nhau.
- Ưu điểm: Ghi cực nhanh, ít tốn CPU.
- Nhược điểm: Khuếch đại không gian (Space Amplification) lên tới ; việc đọc chậm vì phải kiểm tra nhiều file SSTable.
- LCS (Leveled): Tổ chức dữ liệu thành các Level cố định (). Từ trở đi, các SSTable trong cùng 1 Level hoàn toàn không bị chồng chéo dải khóa.
- Ưu điểm: Tối ưu hóa không gian lưu trữ tuyệt đối (chỉ tốn đĩa phụ); tốc độ đọc cực nhanh vì mỗi Level chỉ cần đọc tối đa 1 SSTable.
- Nhược điểm: Tốn nhiều I/O đĩa và CPU hơn cho tiến trình Compaction liên tục.
- STCS (Size-Tiered): Gom các file SSTable có kích cỡ bằng nhau lại để gộp thành file lớn hơn. Các file này có thể chứa dải khóa trùng lặp nhau.
- Bắt buộc chuyển sang LCS khi:
- Hệ thống có tỷ lệ Đọc cao (Read-Heavy hoặc Read/Write): Cần đảm bảo độ trễ đọc P99 thấp và ổn định.
- Đĩa cứng gần đầy (Disk Capacity Constraints): Khi dung lượng dữ liệu chiếm ổ đĩa, STCS sẽ bị treo do không đủ dung lượng trống để chạy Compaction, buộc phải dùng LCS để tối ưu hóa không gian.
- Ứng dụng có nhiều thao tác Cập nhật (
UPDATE) và Xóa (DELETE): LCS dọn dẹp các bản ghi rác Tombstone và bản ghi cũ nhanh hơn nhiều so với STCS.
- So sánh cốt lõi:
6. Tóm Tắt Ghi Nhớ Nhanh (Key Takeaways)
- B-Tree dùng In-Place Updates (Tối ưu cho Đọc, kém cho Ghi lớn); LSM-Tree dùng Append-Only Logging (Tối ưu tuyệt đối cho Ghi phân tán quy mô lớn).
- LSM-Tree bao gồm 4 thành phần trụ cột: WAL (Bền vững) + MemTable (RAM SkipList) + SSTables (Đĩa tuần tự) + Bloom Filters (Loại trừ đọc trượt).
- Bloom Filter đảm bảo False Negatives; tinh chỉnh để triệt tiêu thao tác đọc đĩa vô ích.
- Chọn Size-Tiered (STCS) cho ứng dụng thuần Ghi (Write-Heavy); chọn Leveled (LCS) cho ứng dụng Cân bằng / Đọc nhiều và tiết kiệm dung lượng đĩa.
- Kiểm soát Write Stalls bằng cách tăng luồng Compaction nền và nới rộng ngưỡng đệm Level 0 Slowdown Triggers.