[Tech Blog #05 | Data Analytics] SQL Phân Tích Thực Chiến: Thứ Tự Thực Thi, Ranh Giới WHERE vs. HAVING & Tuyệt Chiêu JOIN Bảng
1. Đặt vấn đề: Nghịch lý "Viết một đằng, Database chạy một nẻo"
Khi mới học SQL, hầu hết mọi người đều viết câu lệnh theo cấu trúc quen thuộc:
SELECT ... FROM ... WHERE ... GROUP BY ... HAVING ... ORDER BY ...
Tuy nhiên, có hai lỗi kinh điển mà người mới bắt đầu (và cả người đi phỏng vấn) thường xuyên mắc phải:
- Lỗi Alias: Đặt bí danh ở
SELECT(ví dụ:SELECT price * quantity AS total_revenue) nhưng khi đemWHERE total_revenue > 1000thì database báo lỗiColumn does not exist. - Lỗi Aggregate: Viết
WHERE COUNT(order_id) > 5và bị database từ chối thẳng thừng.
Nguyên nhân cốt lõi: Thứ tự bạn viết câu lệnh (Lexical Order) hoàn toàn khác với Thứ tự mà bộ xử lý cơ sở dữ liệu thực thi (Logical Execution Order).
2. Thứ tự thực thi chuẩn của SQL Engine (Execution Order)
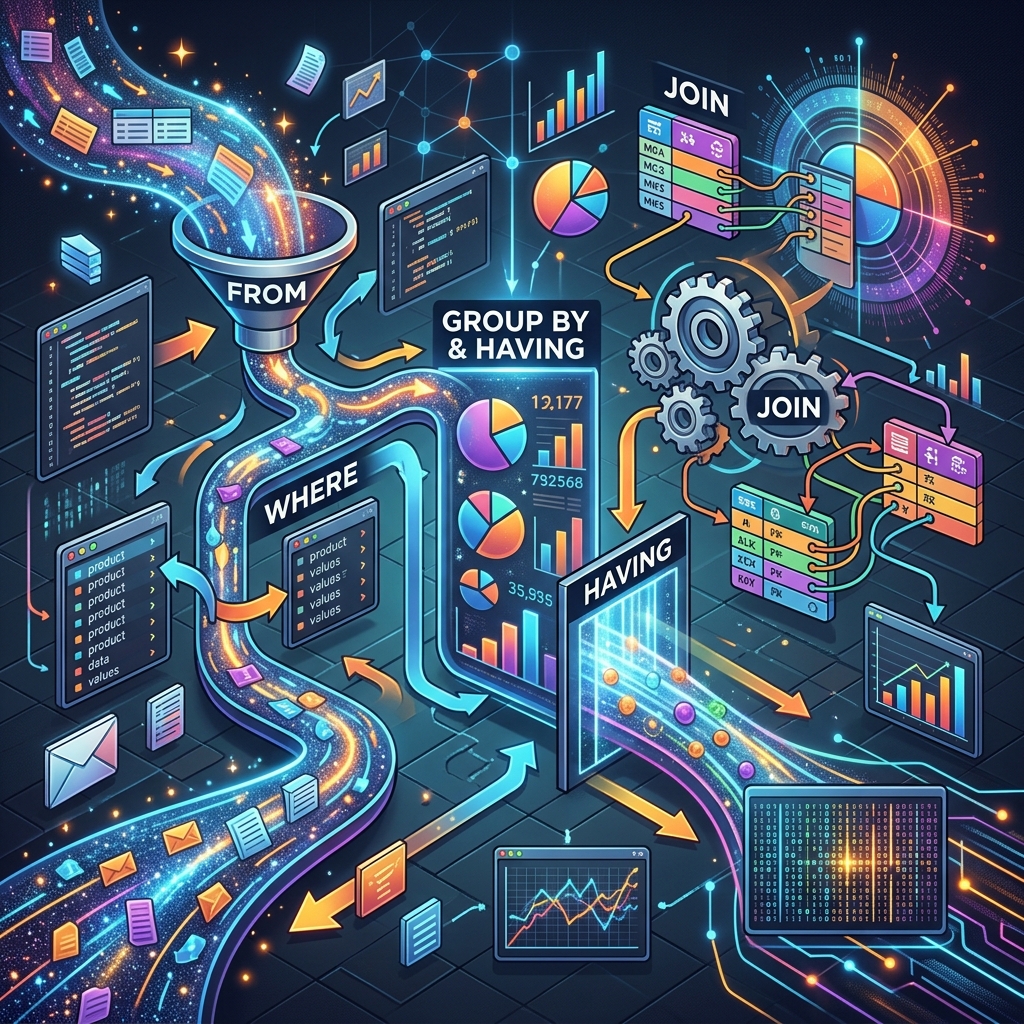
Hãy thuộc lòng quy trình 8 bước mà Database Engine (PostgreSQL, ClickHouse, MySQL, Snowflake) thực sự xử lý câu truy vấn của bạn:
[1. FROM & JOIN]  ---> Nạp các bảng và ghép nối dòng dữ liệu
      ↓
[2. WHERE]        ---> Lọc từng dòng đơn lẻ (Row-level filter)
      ↓
[3. GROUP BY]     ---> Gom các dòng dữ liệu thỏa mãn vào từng nhóm
      ↓
[4. HAVING]       ---> Lọc trên các nhóm sau khi tính toán tổng hợp (Group-level filter)
      ↓
[5. SELECT]       ---> Chọn cột hiển thị, tính toán biểu thức, gán Alias
      ↓
[6. DISTINCT]     ---> Loại bỏ các dòng trùng lặp (nếu có)
      ↓
[7. ORDER BY]     ---> Sắp xếp kết quả (Lúc này MỚI dùng được Alias ở bước SELECT!)
      ↓
[8. LIMIT/OFFSET] ---> Cắt lấy số lượng dòng mong muốn
Lời giải cho hai câu hỏi hóc búa ở mục 1:
- Tại sao
WHEREkhông nhận Alias? VìWHERE(Bước 2) chạy trướcSELECT(Bước 5). Khi đang ở bước 2, Database chưa hề biết Alias bạn định đặt là gì.- Tại sao
WHEREkhông dùng được với hàm tổng hợp (COUNT,SUM,AVG)? VìWHERElọc dữ liệu thô trước khi gom nhóm (GROUP BY- Bước 3). Muốn lọc sau khi đã tính tổng/đếm nhóm, bạn bắt buộc phải dùngHAVING(Bước 4).
3. Phân biệt rạch ròi: WHERE vs. HAVING
| Đặc điểm | Mệnh đề WHERE | Mệnh đề HAVING |
|---|---|---|
| Thời điểm chạy | Trước khi gom nhóm (GROUP BY). | Sau khi đã gom nhóm (GROUP BY). |
| Phạm vi tác động | Từng dòng dữ liệu riêng lẻ (Row level). | Từng nhóm bản ghi đã tổng hợp (Aggregate group level). |
Hàm tổng hợp (SUM, COUNT...) | ❌ Nghiêm cấm sử dụng. | ✅ Chuyên dùng để lọc các hàm tổng hợp. |
| Hiệu năng (Performance) | Rất nhanh vì loại bỏ dữ liệu thừa sớm, giảm tải tính toán. | Chậm hơn nếu lạm dụng, vì phải nạp và gom nhóm xong mới lọc. |
Quy tắc vàng tối ưu hóa truy vấn: Nếu một điều kiện có thể lọc được bằng
WHERE, hãy luôn dùngWHEREthay vì đợi đếnHAVING. Chỉ dùngHAVINGcho những điều kiện bắt buộc phải dùng hàm tổng hợp (ví dụ:HAVING SUM(amount) > 1000000).
4. Tuyệt chiêu JOIN: Đọc hiểu 4 phép ghép bảng kinh điển
Giả sử ta có 2 bảng: customers (Khách hàng) và orders (Đơn hàng).
  Bảng Customers             Bảng Orders
+----+-------------+      +----------+----+--------+
| id | name        |      | order_id | id | amount |
+----+-------------+      +----------+----+--------+
| 1  | Alice       |      | 101      | 1  | 500    |
| 2  | Bob         |      | 102      | 1  | 300    |
| 3  | Charlie     |      | 103      | 2  | 700    |
| 4  | David (Chưa mua)   | 104      | 99 | 150 (Đơn mồ côi)|
+----+-------------+      +----------+----+--------+
- INNER JOIN (Giao nhau): Chỉ giữ lại các bản ghi khớp mã giữa 2 bảng.
- Kết quả: Chỉ hiện Alice (id 1) và Bob (id 2). David và đơn 104 bị loại bỏ.
- LEFT JOIN (Ưu tiên bảng trái): Giữ lại toàn bộ dòng của bảng bên trái (
customers). Dòng nào không có đơn hàng thì các cột của bảngorderssẽ mang giá trịNULL.- Ứng dụng thực tế: Tìm xem ai là người chưa mua hàng (
WHERE orders.order_id IS NULL).
- Ứng dụng thực tế: Tìm xem ai là người chưa mua hàng (
- RIGHT JOIN (Ưu tiên bảng phải): Giữ lại toàn bộ dòng của bảng bên phải. Trong thực tế phân tích, người ta ít dùng
RIGHT JOINmà đảo vị trí bảng để dùngLEFT JOINcho code dễ đọc từ trái sang phải. - FULL OUTER JOIN (Gộp tất cả): Giữ lại toàn bộ khách hàng và toàn bộ đơn hàng, kể cả khách chưa mua lẫn đơn mồ côi.
5. Thực hành thực chiến: Phân tích hiệu suất khách hàng bằng SQL
Dưới đây là một truy vấn thực tế kết hợp LEFT JOIN, GROUP BY, HAVING, và kỹ thuật Conditional Aggregation (SUM(CASE WHEN...)) để phân loại doanh thu:
-- Bài toán: Tìm các khách hàng VIP có tổng chi tiêu thành công trên 1.000.000 VNĐ,
-- đồng thời thống kê số đơn thành công vs. số đơn bị hủy của từng người.

SELECT
    c.customer_id,
    c.full_name,
    c.city,

    -- Đếm tổng số đơn hàng khách đã tạo (Kể cả thành công hay hủy)
    COUNT(o.order_id) AS total_orders_created,

    -- Kỹ thuật Conditional Aggregation: Đếm riêng số đơn hoàn tất
    COUNT(CASE WHEN o.status = 'COMPLETED' THEN 1 END) AS successful_orders,

    -- Kỹ thuật Conditional Aggregation: Tính tổng tiền chỉ cho đơn hoàn tất
    -- Dùng COALESCE để đổi NULL thành 0 nếu khách chưa có đơn thành công nào
    COALESCE(SUM(CASE WHEN o.status = 'COMPLETED' THEN o.total_amount ELSE 0 END), 0) AS total_spent_completed

FROM
    customers c

    -- Dùng LEFT JOIN để không bỏ sót những khách hàng mới đăng ký
    LEFT JOIN orders o ON c.customer_id = o.customer_id

-- 1. Lọc thô ở cấp độ dòng: Chỉ xét khách hàng đăng ký từ năm 2025 trở lại đây
WHERE
    c.created_at >= '2025-01-01'

-- 2. Gom nhóm theo từng khách hàng
GROUP BY
    c.customer_id,
    c.full_name,
    c.city

-- 3. Lọc ở cấp độ nhóm: Chỉ lấy những khách hàng có tổng chi tiêu thực tế > 1.000.000 VNĐ
HAVING
    SUM(CASE WHEN o.status = 'COMPLETED' THEN o.total_amount ELSE 0 END) > 1000000

-- 4. Sắp xếp theo tổng tiền giảm dần (Ở bước này ĐÃ nhận diện được Alias 'total_spent_completed')
ORDER BY
    total_spent_completed DESC

-- 5. Lấy ra Top 10 khách hàng chi tiêu nhiều nhất
LIMIT 10;
6. Câu hỏi phỏng vấn thực tế (Interview Q&A)
Câu 1 (Mức độ: Entry / Junior)
Câu hỏi: "Làm thế nào để tìm ra danh sách tất cả khách hàng chưa từng phát sinh bất kỳ đơn hàng nào bằng SQL?"
Gợi ý trả lời:
*"Cách trực quan và phổ biến nhất là sử dụngLEFT JOINkết hợp điều kiệnWHERE ... IS NULL:SELECT c.customer_id, c.full_name FROM customers c LEFT JOIN orders o ON c.customer_id = o.customer_id WHERE o.order_id IS NULL;Khi dùng LEFT JOIN, những khách hàng chưa mua hàng sẽ có cột
o.order_idmang giá trị NULL. Ta chỉ cần lọc những dòng này là có ngay kết quả. Ngoài ra, trong trường hợp bảng dữ liệu rất lớn, em có thể cân nhắc dùng cú phápWHERE NOT EXISTS (...)để tối ưu hóa hiệu năng quét chỉ mục."*
Câu 2 (Mức độ: Junior / Mid-level)
Câu hỏi: "Tại sao câu lệnh dưới đây bị lỗi và cách sửa chuẩn nhất là gì?"
SELECT department_id, AVG(salary) AS avg_sal
FROM employees
WHERE avg_sal > 20000000
GROUP BY department_id;
Gợi ý trả lời:
*"Câu lệnh này mắc cả hai lỗi cơ bản về thứ tự thực thi:
- Mệnh đề
WHEREđược thực thi trước mệnh đềSELECT, nên tại thời điểm chạyWHERE, Database chưa biếtavg_sallà gì.AVG(salary)là một hàm tổng hợp (Aggregate Function), không thể đặt trong mệnh đềWHEREvì WHERE lọc trên từng dòng dữ liệu thô trước khi gom nhóm.
Cách sửa đúng: Chuyển điều kiện lọc sang mệnh đềHAVING:SELECT department_id, AVG(salary) AS avg_sal FROM employees GROUP BY department_id HAVING AVG(salary) > 20000000; ```"*
7. Key Takeaways (Ghi nhớ nhanh)
- Thuộc nằm lòng chuỗi thực thi:
FROM/JOINWHEREGROUP BYHAVINGSELECTORDER BYLIMIT. - WHERE lọc dòng, HAVING lọc nhóm: Hãy tận dụng
WHEREtối đa để gạt bỏ bớt dữ liệu trước khi nạp vàoGROUP BY. - Tuyệt chiêu SUM(CASE WHEN ...): Đây là vũ khí mạnh nhất để tính toán các chỉ số kinh doanh đa điều kiện trong cùng một câu lệnh mà không cần
JOINnhiều lần. - Cẩn trọng với NULL trong JOIN: Khi dùng
LEFT JOIN, hãy luôn chuẩn bị hàmCOALESCE(column, 0)để tránh bị trả về kết quả rỗng ngoài ý muốn.