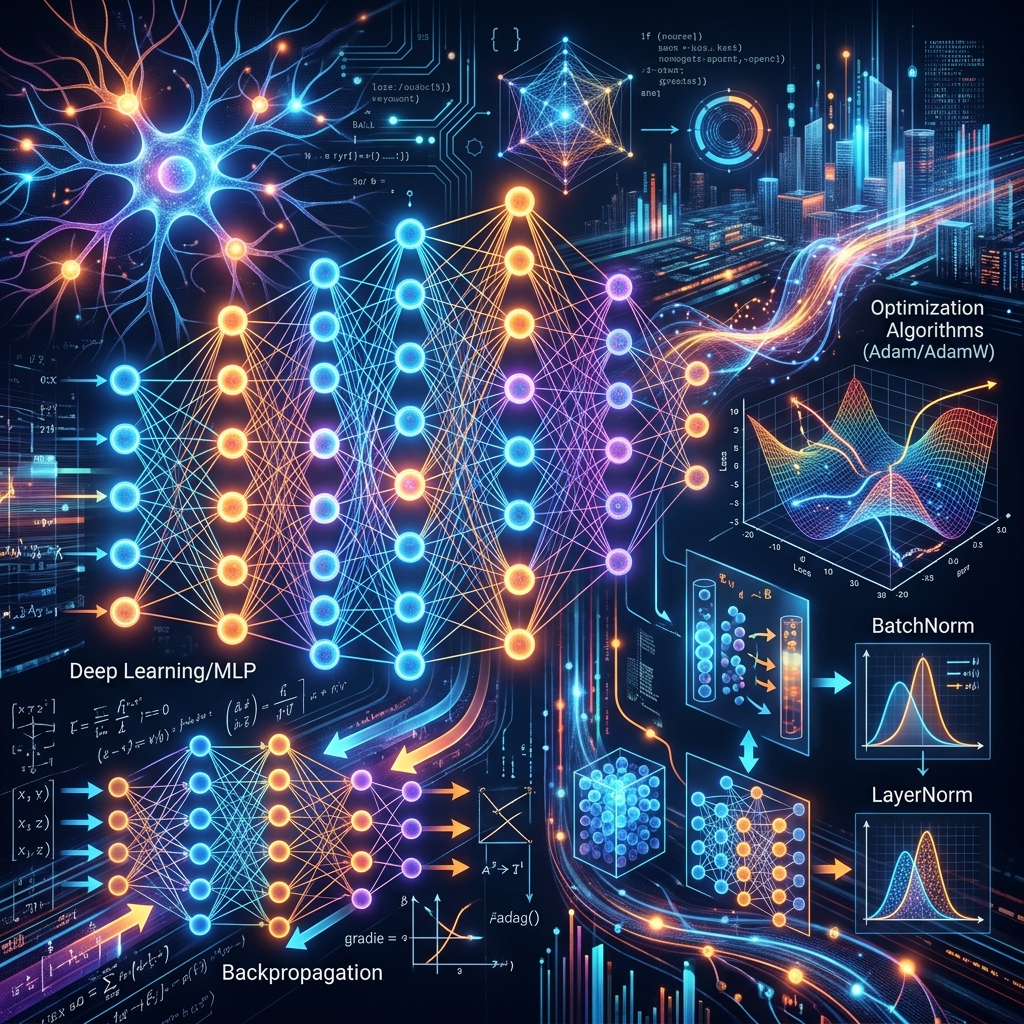
[AI Blog #28] Nền Tảng Deep Learning & Trí Tuệ Nhân Tạo: Mạng Nơ-ron Sâu (MLP), Giải Mã Lan Truyền Ngược (Backpropagation), Thuật Toán Tối Ưu Hóa (Adam/AdamW) & Kỹ Thuật Chuẩn Hóa (BatchNorm vs. LayerNorm)
1. Bối cảnh thực tế (Context & Problem Statement)
Trong khi Machine Learning truyền thống (Scikit-Learn, XGBoost) dựa rất nhiều vào việc con người phải tự tay trích xuất đặc trưng (Manual Feature Engineering), Deep Learning (Học sâu) tạo nên cuộc cách mạng nhờ khả năng Học biểu diễn tự động (Hierarchical Representation Learning):
- Các tầng đầu tiên học các đặc trưng cấp thấp (đường nét, cạnh, âm vị).
- Các tầng sâu hơn tự động kết hợp thành các khái niệm trừu tượng cấp cao (khuôn mặt đồ vật, ngữ nghĩa câu văn).
Tuy nhiên, việc huấn luyện một mạng nơ-ron sâu với hàng chục tầng hoặc các mô hình ngôn ngữ lớn (LLMs) với hàng tỷ tham số thường xuyên gặp phải những "cơn ác mộng" toán học: Biến mất đạo hàm (Vanishing Gradient), Bùng nổ đạo hàm (Exploding Gradient), Mất ổn định nội tại (Internal Covariate Shift).
Để làm chủ Deep Learning hiện đại, bạn bắt buộc phải hiểu rõ cơ chế vận hành bên dưới của Backpropagation, Optimizers, và Normalization.
2. Các Khái Niệm & Cơ Chế Cốt Lõi
2.1. Kiến Trúc Mạng Nơ-ron Truyền Thẳng (Multi-Layer Perceptron - MLP)
Một nơ-ron nhân tạo đơn lẻ thực hiện 2 phép tính toán cơ bản:
- Linear Combination (Tổ hợp tuyến tính):
- Non-linear Activation (Hàm kích hoạt phi tuyến):
- Tại sao cần hàm phi tuyến? Nếu không có hàm kích hoạt phi tuyến, việc xếp chồng 100 lớp nơ-ron dày đặc cũng chỉ tương đương với 1 phép biến đổi tuyến tính đơn lẻ (), khiến mạng không thể học được các quy luật phi tuyến phức tạp trong thế giới thực.
2.2. Bản Chất Toán Học Của Lan Truyền Ngược (Backpropagation & Chain Rule)
Mục tiêu của quá trình huấn luyện là tìm bộ trọng số sao cho hàm mất mát (Loss Function) đạt giá trị nhỏ nhất.
- Thuật toán Gradient Descent cập nhật trọng số theo hướng ngược chiều vector đạo hàm: (trong đó là Tốc độ học - Learning Rate).
- Quy tắc chuỗi (Chain Rule) trong Đồ thị tính toán (Computational Graph):
- Vấn đề Vanishing Gradient (Biến mất đạo hàm):
- Khi sử dụng hàm kích hoạt Sigmoid () hoặc Tanh (), việc nhân liên tiếp hàng chục số thập phân qua nhiều tầng ẩn sẽ khiến đạo hàm ở các tầng đầu tiên tiến về ().
- Các tầng đầu tiên ngừng học hoàn toàn!
- Giải pháp: Sử dụng ReLU (), LeakyReLU, hoặc GeLU (trong Transformers) có đạo hàm bằng khi , triệt tiêu hiện tượng bão hòa gradient.
FORWARD PASS:
Input (X) ---> [ Layer 1: z1 = W1*X+b1 -> a1 = ReLU(z1) ] ---> [ Layer 2: z2 = W2*a1+b2 ] ---> Loss (L)

BACKWARD PASS (Chain Rule):
dL/dW1 <=== [ dL/dz1 = (dL/dz2 * W2) * ReLU'(z1) ] <=== [ dL/dz2 = dL/da_out * ... ] <=== dL
2.3. Tiến Hóa Của Các Thuật Toán Tối Ưu Hóa (Optimizers)
- SGD (Stochastic Gradient Descent): Cập nhật dựa trên từng batch nhỏ, dễ bị dao động răng cưa và mắc kẹt tại điểm yên ngựa (Saddle Points).
- SGD with Momentum: Bổ sung quán tính vật lý (vận tốc ) giúp vượt qua các vùng phẳng và triệt tiêu dao động ngang.
- RMSprop: Tự động điều chỉnh Learning Rate cho từng tham số bằng cách chia cho căn bậc hai của trung bình bình phương gradient lịch sử ().
- Adam (Adaptive Moment Estimation): Kết hợp cả Momentum (First Moment - Hướng đi) và RMSprop (Second Moment - Độ lớn bước nhảy).
- AdamW (Adam with Decoupled Weight Decay - Tiêu chuẩn vàng hiện nay): Tách rời phép phạt Regularization ra khỏi việc tính toán gradient thích ứng, khắc phục nhược điểm lớn của Adam trên các mô hình ngôn ngữ lớn (Transformers/LLMs).
2.4. Kỹ Thuật Chuẩn Hóa: BatchNorm vs. LayerNorm vs. RMSNorm
- Batch Normalization (BatchNorm): Chuẩn hóa dữ liệu trên chiều Batch () cho từng kênh/thuộc tính độc lập.
- Rất mạnh trong Computer Vision (CNN) nhưng phụ thuộc vào kích thước Batch Size và thất bại trên dữ liệu chuỗi có độ dài biến thiên (NLP).
- Layer Normalization (LayerNorm): Chuẩn hóa dữ liệu trên toàn bộ các thuộc tính/chiều ẩn () của duy nhất 1 mẫu dữ liệu đơn lẻ, độc lập hoàn toàn với các mẫu khác trong Batch.
- Là tiêu chuẩn bắt buộc cho kiến trúc Transformer, BERT, GPT và LLMs.
- RMSNorm (Root Mean Square Layer Normalization): Biến thể tối ưu hóa của LayerNorm bỏ qua việc tính giá trị trung bình , chỉ chia cho giá trị căn bậc hai trung bình bình phương (RMS), giúp tăng tốc độ tính toán (được dùng trong LLaMA 2/3, Mistral).
3. Các Bảng Markdown So Sánh Chi Tiết
📊 Bảng 1: So Sánh Toàn Diện Các Hàm Kích Hoạt (Activation Functions)
| Hàm kích hoạt | Công thức toán học | Miền giá trị | Đạo hàm lớn nhất | Ưu điểm & Nhược điểm | Use-case phổ biến |
|---|---|---|---|---|---|
| Sigmoid | Dễ bị Vanishing Gradient, không Zero-centered | Tầng đầu ra của bài toán phân loại nhị phân (Binary Classification) | |||
| Tanh | Zero-centered tốt hơn Sigmoid, vẫn bị Vanishing Gradient | Tầng ẩn của RNN cổ điển | |||
| ReLU | Tính toán siêu nhanh (), không bão hòa gradient dương. Nhược điểm: Dying ReLU | Chuẩn mặc định cho Mạng nơ-ron tích chập (CNN), MLP | |||
| GeLU | (Gaussian Error) | Làm mượt màng chuyển tiếp xác suất, hiệu năng vượt trội trên dữ liệu phức tạp | Chuẩn mực trong Transformer, BERT, GPT-3/4 | ||
| Swish / SiLU | Mượt mà, cải thiện độ dốc gradient ở vùng âm | LLaMA, EfficientNet, YOLOv8 |
📊 Bảng 2: So Sánh Các Thuật Toán Tối Ưu Hóa (Optimizers)
| Thuật toán | Cơ chế học Learning Rate | Khả năng thoát khỏi Yên ngựa (Saddle Points) | Bộ nhớ phụ trợ yêu cầu | Use-case tối ưu |
|---|---|---|---|---|
| SGD + Momentum | Cố định toàn cục (kèm quán tính) | Khá | Thấp ( bộ nhớ trọng số) | Computer Vision (ResNet), Đạt độ tổng quát hóa cao |
| RMSprop | Tự thích ứng theo từng tham số (Adaptive) | Tốt | Trung bình | Bài toán không dừng (Non-stationary), RNN |
| Adam | Kết hợp Momentum + RMSprop | Rất tốt | Cao ( bộ nhớ: Momentum + Variance) | Huấn luyện nhanh cho hầu hết các tác vụ Deep Learning |
| AdamW | Tách rời Weight Decay khỏi Adam Adaptive Gradient | Xuất sắc nhất | Cao ( bộ nhớ) | Chuẩn mực bắt buộc cho Transformers, LLMs, Diffusion Models |
📊 Bảng 3: So Sánh BatchNorm vs. LayerNorm vs. RMSNorm
| Tiêu chí | Batch Normalization (BatchNorm) | Layer Normalization (LayerNorm) | RMSNorm (Root Mean Square) |
|---|---|---|---|
| Phạm vi tính toán | Gom dọc theo chiều Batch () | Gom ngang qua các Features () của 1 mẫu | Chỉ tính RMS ngang qua Features () (Không tính ) |
| Phụ thuộc Batch Size | Rất lớn (Batch size nhỏ hoạt động rất kém) | Không phụ thuộc (Chạy tốt cả khi Batch Size ) | Không phụ thuộc |
| Hành vi Train vs. Inference | Khác nhau (Lưu Running Mean/Var lúc Train) | Hoàn toàn đồng nhất giữa Train và Inference | Hoàn toàn đồng nhất |
| Tốc độ tính toán | Nhanh trên GPU | Trung bình (cần tính Mean và Var) | Nhanh nhất (Tiết kiệm 20% thời gian tính toán) |
| Lĩnh vực thống trị | Computer Vision (CNN, ResNet) | Transformers (BERT, GPT, T5) | State-of-the-Art LLMs (LLaMA 2/3, Mistral, Gemma) |
4. Best Practices & Kỹ Thuật Huấn Luyện Mạng Sâu (Pro-Tips)
💡 Kỹ thuật Khởi tạo Trọng số (Weight Initialization)
- Tuyệt đối không khởi tạo toàn bộ : Nếu mọi trọng số bằng , tất cả các nơ-ron ở cùng một tầng sẽ có đầu ra giống hệt nhau và nhận cùng một gradient (hiện tượng đối xứng - Symmetry Problem), khiến mạng không thể học được các tính chất đa dạng.
- Quy tắc chọn khởi tạo:
- Nếu dùng ReLU / LeakyReLU: Sử dụng He Initialization (Kaiming Init) ().
- Nếu dùng Sigmoid / Tanh / GeLU: Sử dụng Xavier / Glorot Initialization ().
💡 Chiến lược Learning Rate Schedule: Cosine Annealing with Warmup
Trong huấn luyện Transformers/LLMs:
- Warmup Phase (5%–10% bước đầu): Tăng dần Learning Rate từ lên giá trị đỉnh để ổn định các lớp nơ-ron ban đầu.
- Cosine Decay Phase: Giảm dần Learning Rate theo đồ thị hàm Cosine về gần để mô hình hội tụ mượt mà vào đáy của vùng cực tiểu toàn cục.
Learning Rate (LR)
      ^
η_max |       / \
      |      /   \  <-- Cosine Decay
      |     /     \
      |    /       \____
      |   / Warmup      \
    0 +--------------------------> Training Steps
5. Góc Ôn Luyện Phỏng Vấn (Interview Corner)
❓ Câu hỏi 1: Giải thích hiện tượng Vanishing Gradient và Exploding Gradient trong Deep Neural Networks. Những kỹ thuật kiến trúc hiện đại nào giúp giải quyết triệt để vấn đề này?
- Gợi ý trả lời:
- Vanishing Gradient (Biến mất đạo hàm):
- Khi đạo hàm ở các tầng đầu tiên tiến sát về do nhân chuỗi (Chain Rule) các giá trị đạo hàm nhỏ qua nhiều tầng ẩn. Trọng số ở các tầng đầu gần như không đổi, mô hình không thể học được biểu diễn cấp thấp.
- Giải pháp: Dùng hàm kích hoạt ReLU / GeLU thay cho Sigmoid; sử dụng He/Xavier Initialization; áp dụng Normalization (BatchNorm/LayerNorm); và quan trọng nhất là sử dụng Residual Connections (Skip Connections: ) trong ResNet/Transformers giúp gradient truyền thẳng không bị suy giảm ().
- Exploding Gradient (Bùng nổ đạo hàm):
- Khi các giá trị đạo hàm nhân chuỗi qua nhiều tầng khiến trọng số tăng vọt tới vô cùng (), làm đồ thị hàm mất mát dao động dữ dội và phân kỳ.
- Giải pháp: Áp dụng Gradient Clipping (cắt gọt vector gradient nếu chuẩn vượt quá một ngưỡng quy định, ví dụ
max_norm = 1.0).
- Vanishing Gradient (Biến mất đạo hàm):
❓ Câu hỏi 2: So sánh cơ chế của Batch Normalization (BatchNorm) và Layer Normalization (LayerNorm). Tại sao BatchNorm lại cực kỳ phổ biến trong Computer Vision nhưng lại thất bại trên Natural Language Processing (Transformers) và buộc phải thay thế bằng LayerNorm?
- Gợi ý trả lời:
- Sự khác biệt về trục chuẩn hóa:
- Giả sử tensor dữ liệu có kích thước (: Batch size, : Độ dài câu Sequence Length, : Số chiều Hidden Dimension):
- BatchNorm: Tính dọc theo trục cho từng vị trí token độc lập.
- LayerNorm: Tính dọc theo trục cho từng token của từng câu đơn lẻ.
- Lý do BatchNorm thất bại trong NLP:
- Độ dài câu biến thiên (Variable Sequence Lengths): Các câu văn trong một batch có độ dài ngắn khác nhau (phải dùng đệm
<pad>). Ở các vị trí token xa, số lượng câu hợp lệ rất ít khiến việc tính toán theo chiều batch bị nhiễu loạn và sai lệch nghiêm trọng. - Phụ thuộc vào Batch Size: Trong các mô hình LLM lớn, do giới hạn VRAM GPU, Batch Size trên mỗi GPU thường rất nhỏ ( hoặc ). BatchNorm hoạt động cực kém khi batch size nhỏ.
- Không đồng nhất giữa Train và Test: LayerNorm tính toán thống kê trực tiếp trên từng câu độc lập, đảm bảo hành vi lúc huấn luyện và lúc suy luận (Inference/Generation từng token) hoàn toàn giống nhau .
- Độ dài câu biến thiên (Variable Sequence Lengths): Các câu văn trong một batch có độ dài ngắn khác nhau (phải dùng đệm
- Sự khác biệt về trục chuẩn hóa:
❓ Câu hỏi 3: Tại sao AdamW lại vượt trội hơn Adam truyền thống khi kết hợp với Regularization (Weight Decay)?
- Gợi ý trả lời:
- Trong thuật toán SGD truyền thống, việc cộng thêm thành phần phạt Regularization () vào hàm mất mát hoàn toàn tương đương với việc thực hiện Weight Decay (trừ trực tiếp một tỷ lệ trọng số cũ: ).
- Tuy nhiên, trong Adam truyền thống, đạo hàm của thành phần phạt () bị đưa vào chung với gradient thực tế để tính toán các giá trị trung bình và phương sai thích ứng .
- Hệ quả: Các trọng số có gradient lịch sử lớn sẽ bị phạt ít hơn, trong khi các trọng số ít biến động lại bị phạt nhiều hơn Làm mất đi ý nghĩa ban đầu của việc kiểm soát độ lớn trọng số.
- Giải pháp của AdamW: Tách rời (Decoupled) hoàn toàn phép tính Weight Decay ra khỏi bước cập nhật gradient thích ứng: Điều này giúp mô hình đạt được khả năng tổng quát hóa (Generalization) vượt trội trên tập kiểm thử, trở thành tiêu chuẩn bắt buộc cho mọi mô hình Transformer/LLM hiện đại.
6. Tóm Tắt Ghi Nhớ Nhanh (Key Takeaways)
- Activation Function: Sử dụng GeLU / Swish cho Transformers/LLMs; sử dụng ReLU cho CNN/MLP cơ bản.
- Backpropagation: Dựa trên quy tắc chuỗi (Chain Rule); giải quyết Vanishing Gradient bằng Skip Connections () và He Initialization.
- Optimizer: AdamW là chuẩn mực số 1 cho Deep Learning hiện đại nhờ tách rời Weight Decay khỏi Adaptive Gradients.
- Normalization: BatchNorm thống trị Computer Vision; LayerNorm & RMSNorm thống trị Natural Language Processing & Large Language Models.