[AI & GenAI Blog #51] Mô Hình Sinh Khuếch Tán (Diffusion Models): Từ VAE, GANs Đến DDPM, Đột Phá Latent Diffusion (Stable Diffusion) & Kỹ Thuật Điều Khiển ControlNet
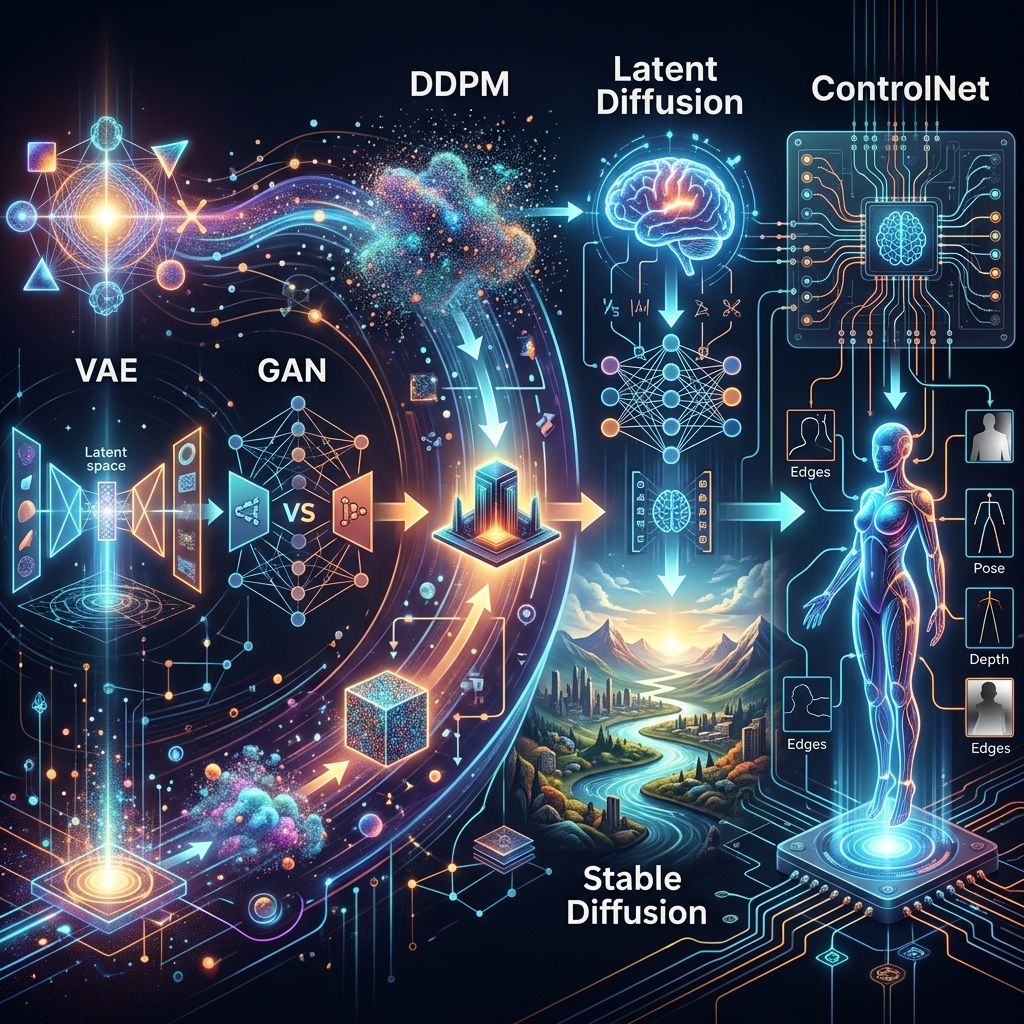
1. Bối cảnh thực tế (Context & Problem Statement)
Trước năm 2020, bài toán sinh dữ liệu hình ảnh nhân tạo bị chi phối bởi hai trường phái:
- Variational Autoencoders (VAE): Tốc độ sinh ảnh nhanh và ổn định, nhưng hình ảnh tạo ra luôn bị mờ (Blurry Images) do hàm mất mát trung bình bình phương (MSE) ép mô hình lấy trung bình các khả năng có thể xảy ra.
- Generative Adversarial Networks (GANs - Ian Goodfellow, 2014): Tạo ra hình ảnh sắc nét tuyệt đẹp nhờ cuộc đối đầu giữa Generator và Discriminator. Tuy nhiên, GANs cực kỳ khó huấn luyện (Notoriously Unstable Training), dễ bị sụp đổ phân phối (Mode Collapse - mô hình chỉ sinh đi sinh lại duy nhất một vài kiểu ảnh) và không thể mở rộng quy mô ổn định.
Năm 2020, bài báo mang tính bước ngoặt "Denoising Diffusion Probabilistic Models (DDPM)" của Jonathan Ho et al. đã mở ra một kỷ nguyên mới:
- Thay vì cố gắng vẽ bức tranh trong 1 bước duy nhất (như GAN/VAE), mô hình học cách xóa bỏ từng chút nhiễu hạt ngẫu nhiên (Denoising step-by-step) qua hàng chục bước.
- Độ ổn định huấn luyện tuyệt đối: Hàm mất mát lồi, không bị Mode Collapse, sinh ảnh đa dạng và sắc nét vượt trội hơn GANs.
Năm 2022, Latent Diffusion Models (LDM / Stable Diffusion) của Runway & Đại học Munich tiếp tục tạo nên cuộc cách mạng: Đưa quá trình khuếch tán từ không gian điểm ảnh (Pixel Space) vào Không gian tiềm ẩn (Latent Space), cho phép tạo ảnh chất lượng cao trên các dòng card đồ họa phổ thông (GPU RTX tiêu chuẩn).
2. Các Khái Niệm & Cơ Chế Cốt Lõi
2.1. Bản Chất Toán Học Của DDPM (Denoising Diffusion Probabilistic Models)
Quá trình khuếch tán được mô hình hóa bằng hai chuỗi Markov đối ngẫu:
FORWARD PROCESS (Thêm nhiễu Gaussian tuần tự - KHÔNG CẦN HỌC):
Ảnh gốc (x_0) ---> [ + Nhiễu t=1 ] ---> [ + Nhiễu t=2 ] ... ---> [ Nhiễu trắng thuần túy (x_T) ]

REVERSE PROCESS (Mạng U-Net học cách khử nhiễu từng bước):
[ Nhiễu trắng (x_T) ] ---> [ U-Net đoán nhiễu ] ---> [ Khử nhiễu t-1 ] ... ---> Ảnh tái tạo (x_0)
1. Quá trình Thuận (Forward Diffusion Process - ):
Liên tục thêm nhiễu Gauss vào ảnh gốc qua bước (thường steps): (trong đó là lịch trình thêm nhiễu Variance Schedule).
- Bí quyết toán học "Nhảy cóc" (Closed-form Sampling): Đặt và . Ta có thể tính toán trực tiếp ảnh bị nhiễu tại bất kỳ bước nào từ ảnh gốc trong 1 phép tính duy nhất mà không cần chạy tuần tự bước:
2. Quá trình Nghịch (Reverse Denoising Process - ):
Bắt đầu từ một vector nhiễu ngẫu nhiên thuần túy , ta cần đảo ngược chuỗi để khôi phục lại ảnh:
- Mục tiêu huấn luyện tối thượng (The Simplified Training Objective): Nghiên cứu của Ho et al. chứng minh rằng thay vì dự đoán trực tiếp ảnh sạch , mạng nơ-ron U-Net chỉ cần học cách dự đoán chính xác vector nhiễu đã được thêm vào tại bước : (Một hàm mất mát MSE cực kỳ đơn giản, ổn định và dễ huấn luyện!).
2.2. Đột Phá Latent Diffusion (Stable Diffusion Architecture)
- Vấn đề của DDPM nguyên bản (Pixel-Space Diffusion): Quá trình khử nhiễu diễn ra trực tiếp trên từng pixel của bức ảnh (ví dụ ảnh giá trị). Chạy mạng U-Net 1000 bước trên không gian này đòi hỏi siêu máy tính khổng lồ.
- Giải pháp Latent Diffusion (Phân tách hai giai đoạn):
- Nén cảm thụ (Perceptual Compression via VAE):
- Huấn luyện một mạng Autoencoder (VAE): Bộ mã hóa (Encoder ) nén bức ảnh từ Pixel Space () xuống Không gian tiềm ẩn (Latent Space ) kích thước chỉ (Nén số chiều dữ liệu mà vẫn giữ trọn vẹn đặc trưng ngữ nghĩa).
- Bộ giải mã (Decoder ) chịu trách nhiệm tái tạo lại ảnh độ phân giải cao từ vector latent sạch.
- Khuếch tán trong không gian tiềm ẩn (Latent Space Diffusion):
- Toàn bộ quá trình thêm nhiễu và khử nhiễu của U-Net chỉ diễn ra trên ma trận nhỏ gọn.
- Tăng tốc độ sinh ảnh gấp và cho phép chạy mượt mà trên các GPU cá nhân ( VRAM)!
- Nén cảm thụ (Perceptual Compression via VAE):
PIXEL SPACE:                Ảnh thô (512x512x3)                                      Ảnh tái tạo (512x512x3)
                                  |                                                            ^
                                  v (VAE Encoder E)                                            | (VAE Decoder D)
LATENT SPACE:                Latent z_0 (64x64x4)                                        Latent sạch z_0
                                  |                                                            ^
                                  v (Thêm nhiễu)                                               | (U-Net Denoising)
                             Latent nhiễu z_T -------------------------------------------------+
                                                     ^
                                                     | (Cross-Attention)
TEXT CONDITIONING:                           [Prompt: "A cat in space"] ---> [CLIP Text Encoder]
2.3. Cơ Chế Điều Khiển Văn Bản & Classifier-Free Guidance (CFG)
Làm thế nào để ép bức ảnh sinh ra phải tuân thủ nghiêm ngặt theo câu lệnh Prompt văn bản?
- Text Conditioning qua Cross-Attention: Câu văn bản được đưa qua CLIP Text Encoder để tạo chuỗi vector ngữ nghĩa. Các vector này được đưa vào các tầng Cross-Attention bên trong mạng U-Net để định hướng dòng chảy khử nhiễu.
- Classifier-Free Guidance (CFG - Ho & Salimans, 2021):
- Tại mỗi bước khử nhiễu, mạng U-Net dự đoán song song 2 giá trị nhiễu:
- : Dự đoán nhiễu có điều kiện prompt (Conditional).
- : Dự đoán nhiễu khi không có prompt (Unconditional / Prompt rỗng).
- Công thức tổng hợp hướng dẫn: (trong đó là Hệ số hướng dẫn - Guidance Scale).
- Tác dụng của CFG: Hệ số (thường chọn ) sẽ khuếch đại độ lệch giữa việc có prompt và không có prompt, ép bức ảnh sinh ra phải bám sát câu lệnh mô tả, loại bỏ các chi tiết mơ hồ.
- Tại mỗi bước khử nhiễu, mạng U-Net dự đoán song song 2 giá trị nhiễu:
2.4. ControlNet: Kiểm Soát Cấu Trúc Không Gian Tuyệt Đối (Zhang et al., 2023)
Prompt văn bản chỉ mô tả được khái niệm chung, nhưng bất lực trong việc chỉ định vị trí chính xác (ví dụ: tư thế người mẫu đứng như thế nào, bố cục tòa nhà ra sao).
- Kiến trúc ControlNet:
- Khóa cứng (Freeze) toàn bộ trọng số của mạng U-Net gốc của Stable Diffusion để bảo toàn khả năng sinh ảnh đẹp.
- Tạo một Bản sao có thể huấn luyện (Trainable Copy) của các khối mã hóa (Encoder Blocks).
- Kết nối bản sao này với mạng gốc thông qua các tầng tích chập đặc biệt gọi là Zero Convolutions (Ma trận trọng số và bias được khởi tạo toàn bộ bằng ).
- Cho phép nạp thêm các điều kiện không gian phức tạp (Đường viền Canny Edge, Dáng người OpenPose, Bản đồ độ sâu Depth Map) để tạo ra bức ảnh có bố cục chính xác theo ý muốn!
Control Input (OpenPose / Canny Edge)
          |
          v
[Trainable Copy of U-Net Blocks] ---> [Zero Convolution (Init=0)]
                                                      |
                                                      v (+)
[Frozen Stable Diffusion U-Net] ----------------------+-----> Output Image
3. Các Bảng Markdown So Sánh Chi Tiết
📊 Bảng 1: So Sánh Toàn Diện Các Họ Mô Hình Sinh (Generative Paradigms)
| Tiêu chí | Variational Autoencoder (VAE) | Generative Adversarial Network (GAN) | Diffusion Models (DDPM / LDM) | Autoregressive Models (PixelCNN) |
|---|---|---|---|---|
| Độ ổn định khi huấn luyện | Rất cao (Tối ưu hóa ELBO) | Kém (Dễ bị Mode Collapse, Minimax không ổn định) | Rất cao (Hàm mất mát MSE đơn giản, ổn định) | Rất cao |
| Chất lượng hình ảnh | Kém (Ảnh mờ, mất chi tiết nét) | Rất cao (Rất sắc nét) | Xuất sắc nhất thế giới hiện nay | Tốt |
| Độ đa dạng của mẫu (Diversity) | Tốt | Kém (Thường bỏ qua các chế độ hiếm) | Rất cao (Bao phủ trọn vẹn phân phối thực tế) | Rất cao |
| Tốc độ sinh mẫu (Inference) | Siêu tốc (1 bước duy nhất) | Siêu tốc (1 bước duy nhất qua Generator) | Chậm hơn (Cần bước khử nhiễu) | Cực chậm (Từng pixel tuần tự ) |
| Ứng dụng tiêu biểu | Nén không gian tiềm ẩn, Khử nhiễu | Deepfake thời gian thực, Chuyển đổi phong cách | Midjourney, Stable Diffusion, DALL-E 3, Sora | Sinh audio (WaveNet) |
📊 Bảng 2: So Sánh Pixel-Space Diffusion vs. Latent-Space Diffusion
| Tiêu chí | Pixel-Space Diffusion (DDPM gốc / Google Imagen) | Latent-Space Diffusion (Stable Diffusion) |
|---|---|---|
| Không gian tính toán | Trực tiếp trên ma trận điểm ảnh () | Không gian vector tiềm ẩn nén () |
| Kích thước tensor xử lý | phần tử | phần tử (Giảm ) |
| Yêu cầu phần cứng GPU | Rất cao (Cần cụm A100 / TPU khổng lồ) | Phổ thông (Chạy tốt trên GPU VRAM) |
| Tốc độ sinh 1 bức ảnh | Chậm (Vài chục giây đến vài phút) | Rất nhanh ( với các Sampler hiện đại) |
| Bảo tồn chi tiết vi mô | Cực tốt trên từng điểm ảnh | Phụ thuộc vào chất lượng tái tạo của VAE Decoder |
📊 Bảng 3: So Sánh Các Thuật Toán Lấy Mẫu Khử Nhiễu (Diffusion Schedulers / Samplers)
| Thuật toán Sampler | Số bước lấy mẫu cần thiết | Bản chất toán học | Đặc điểm hiệu năng |
|---|---|---|---|
| DDPM (Gốc) | Chuỗi Markov ngẫu nhiên | Quá chậm, không thể ứng dụng thương mại | |
| DDIM (Implicit) | Quá trình phi Markov (Deterministic ODE) | Nhanh hơn , cho phép đảo ngược ảnh về latent | |
| Euler Ancestral (Euler a) | Giải phương trình vi phân ngẫu nhiên (SDE) | Ảnh biến đổi liên tục khi tăng số bước, phong cách nghệ thuật | |
| DPM++ 2M Karras | Phương trình vi phân bậc hai (Second-order ODE) | Chuẩn mực tối ưu nhất cho Stable Diffusion (Nhanh & Nét) | |
| Flow Matching (SD3 / Flux) | Ánh xạ vận tốc đường thẳng (Optimal Transport) | Thế hệ mới nhất (2024–2026), tốc độ và chi tiết vượt trội |
4. Best Practices & Kỹ Thuật Điều Khiển Sinh Ảnh Thực Chiến (Pro-Tips)
💡 Bí Quyết Điều Chỉnh Tham Số CFG (Guidance Scale)
- Nếu : Bức ảnh có tính sáng tạo cao, màu sắc tự nhiên nhưng không bám sát mô tả trong prompt.
- Nếu : Điểm cân bằng lý tưởng nhất. Bức ảnh tuân thủ câu lệnh và giữ được chi tiết chân thực.
- Nếu : Hiện tượng Cháy ảnh (Oversaturation / Burn-in): Màu sắc bị gắt, tương phản quá đà, xuất hiện viền sắc nhọn giả tạo do vector bị đẩy đi quá xa khỏi phân phối tự nhiên.
💡 Bản Chất Của "Negative Prompt" Trong Classifier-Free Guidance
Trong các công cụ như Midjourney hay Stable Diffusion, người dùng thường nhập Negative Prompt (ví dụ: "ugly, deformed hands, blurry").
- Cơ chế toán học: Thay vì sử dụng nhãn rỗng trong công thức CFG, ta thay thế bằng vector nhúng của Negative Prompt ():
- Mô hình chủ động "đẩy" bức ảnh ra xa khỏi các đặc trưng được mô tả trong Negative Prompt!
5. Góc Ôn Luyện Phỏng Vấn (Interview Corner)
❓ Câu hỏi 1: Giải thích nguyên lý toán học của quá trình Thuận (Forward Process) trong mô hình DDPM. Làm thế nào chúng ta có thể lấy mẫu trực tiếp một bức ảnh bị nhiễu tại bước thời gian bất kỳ () từ ảnh gốc () trong 1 phép tính duy nhất mà không cần chạy đệ quy qua từng bước?
- Gợi ý trả lời:
- Định nghĩa bước chuyển tiếp:
- Tại mỗi bước , ảnh bị thêm nhiễu Gauss độc lập: với và .
- Chứng minh công thức nhảy cóc (Closed-form derivation):
- Thay thế đệ quy vào :
- Do tính chất cộng của hai biến ngẫu nhiên Gauss độc lập , phương sai tổng hợp là:
- Do đó: .
- Tiếp tục khai triển đệ quy ngược về và đặt , ta thu được công thức tổng quát:
- Ý nghĩa trong huấn luyện: Cho phép thuật toán chọn ngẫu nhiên một mốc thời gian bất kỳ, tính toán ngay bức ảnh bị nhiễu trong và đưa vào mạng U-Net để huấn luyện mà hoàn toàn không tốn thời gian chạy đệ quy bước.
- Định nghĩa bước chuyển tiếp:
❓ Câu hỏi 2: So sánh Latent Diffusion Models (LDM / Stable Diffusion) và Pixel-Space Diffusion (như Google Imagen hay DDPM gốc). Tại sao kiến trúc Latent Diffusion lại được coi là bước ngoặt quyết định đưa Generative AI hình ảnh ra ứng dụng thương mại rộng rãi?
- Gợi ý trả lời:
- Sự khác biệt về không gian biểu diễn:
- Pixel-Space Diffusion: Quá trình thêm và khử nhiễu diễn ra trực tiếp trên các điểm ảnh RGB (). Hầu hết các chi tiết ở cấp độ pixel tần số cao (như các nhiễu hạt siêu nhỏ không nhìn thấy được bằng mắt thường) đều bị ép mô hình phải học khử nhiễu Gây lãng phí tài nguyên tính toán khổng lồ vào các chi tiết không mang giá trị ngữ nghĩa.
- Latent Diffusion: Tách rời bài toán làm 2 phần: Dùng VAE để nén dữ liệu từ không gian điểm ảnh vào không gian tiềm ẩn ngữ nghĩa (Latent Space ). Mạng U-Net chỉ tập trung khử nhiễu trên các đặc trưng cấu trúc cốt lõi của bức ảnh.
- Lý do là bước ngoặt thương mại hóa:
- Giảm dung lượng tính toán: Kích thước tensor giảm từ xuống phần tử.
- Dân chủ hóa phần cứng (Democratization of Hardware): Cho phép các nhà nghiên cứu, startup và người dùng cá nhân có thể tự fine-tune (qua LoRA, DreamBooth) và chạy suy luận sinh ảnh trong giây trên các GPU phổ thông dành cho game thủ ( VRAM), thay vì bắt buộc phải thuê các cụm siêu máy tính A100 đắt đỏ.
- Sự khác biệt về không gian biểu diễn:
❓ Câu hỏi 3: Classifier-Free Guidance (CFG) hoạt động như thế nào? Tại sao phương pháp này lại vượt trội hơn hẳn so với Classifier Guidance truyền thống trong việc điều khiển hình ảnh sinh ra bám sát câu lệnh Prompt?
- Gợi ý trả lời:
- Hạn chế của Classifier Guidance truyền thống (Dhariwal & Nichol):
- Đòi hỏi phải huấn luyện riêng một mạng nơ-ron phân loại (Classifier) trên các hình ảnh bị nhiễu .
- Khi lấy mẫu khử nhiễu, thuật toán dùng gradient của bộ phân loại này để uốn nắn hướng đi của U-Net.
- Nhược điểm: Phức tạp, tốn thêm bộ nhớ GPU, và quan trọng nhất là các kỹ sư không thể huấn luyện một bộ phân loại cho mọi mô tả ngôn ngữ tự nhiên tự do không giới hạn của con người.
- Đột phá của Classifier-Free Guidance (CFG):
- Loại bỏ hoàn toàn mạng phân loại độc lập.
- Trong quá trình huấn luyện U-Net, hệ thống ngẫu nhiên bỏ rơi điều kiện prompt (thay bằng prompt rỗng ) với xác suất để mô hình học được cả hai hành vi: Sinh ảnh tự do (Unconditional) VÀ Sinh ảnh có điều kiện (Conditional).
- Khi suy luận, thuật toán lấy vector hiệu số giữa hai hướng đi và nhân với hệ số khuếch đại :
- Ưu điểm vượt trội: Tận dụng trực tiếp năng lực nội tại của U-Net, cực kỳ đơn giản, hoạt động hoàn hảo với bất kỳ văn bản tự do nào từ CLIP Text Encoder và cho phép người dùng tự do điều chỉnh độ bám sát prompt thông qua thanh trượt Guidance Scale .
- Hạn chế của Classifier Guidance truyền thống (Dhariwal & Nichol):
6. Tóm Tắt Ghi Nhớ Nhanh (Key Takeaways)
- Diffusion Models (DDPM) vượt trội hơn GANs nhờ tính ổn định huấn luyện tuyệt đối (không Mode Collapse) và hàm mất mát đơn giản .
- Công thức Closed-form cho phép nhảy cóc tới bước bất kỳ trong : .
- Latent Diffusion (Stable Diffusion) nén ảnh bằng VAE ( reduction), đưa quá trình khử nhiễu vào không gian tiềm ẩn , giải quyết triệt để rào cản phần cứng GPU.
- Classifier-Free Guidance (CFG) khuếch đại hướng đi của vector văn bản với hệ số để ép bức ảnh tuân thủ nghiêm ngặt theo Prompt.
- ControlNet sử dụng Zero Convolutions trên bản sao trainable của U-Net để kiểm soát chính xác bố cục không gian (Dáng người, Đường nét, Độ sâu).