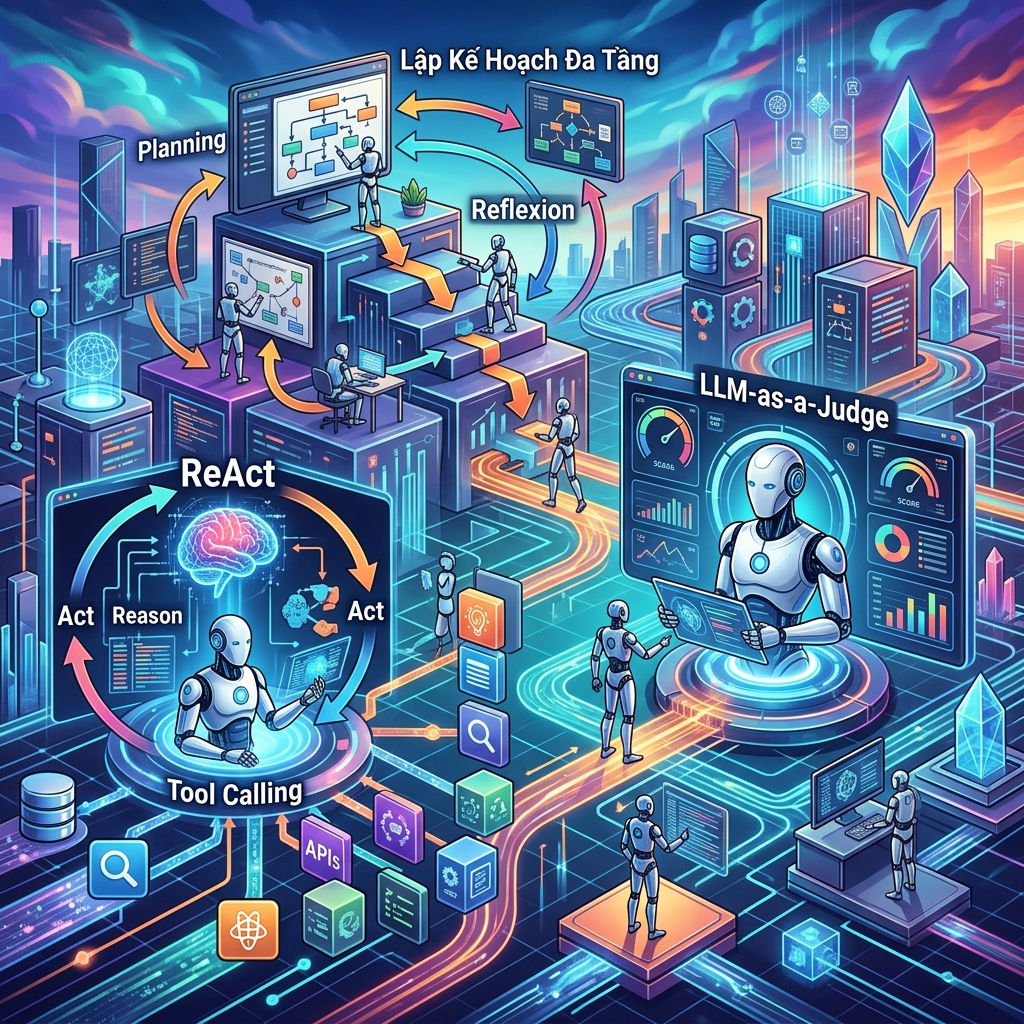
[AI & GenAI Blog #35] Kiến Trúc AI Agents & Hệ Thống Đa Đặc Vụ (Multi-Agent Systems): Khung Phân Tích ReAct, Tool Calling, Lập Kế Hoạch Đa Tầng (Planning & Reflexion) & Đánh Giá LLM-as-a-Judge
1. Bối cảnh thực tế (Context & Problem Statement)
Trong giai đoạn đầu của Generative AI, các ứng dụng chủ yếu dừng lại ở mức Chatbot thụ động hoặc RAG đơn luồng (Naive RAG): Người dùng hỏi một câu Hệ thống tìm kiếm văn bản liên quan LLM sinh câu trả lời trong một lượt tương tác đơn lẻ (Single-Turn Interaction).
Tuy nhiên, các bài toán thực tế phức tạp trong doanh nghiệp không thể giải quyết bằng một câu trả lời duy nhất:
- "Hãy nghiên cứu đối thủ cạnh tranh A, phân tích báo cáo tài chính 3 năm qua trên web, viết code Python vẽ biểu đồ tăng trưởng và gửi email tổng hợp cho ban giám đốc."
Để hoàn thành nhiệm vụ trên, hệ thống cần có khả năng Tự chủ (Autonomy): Tự phân rã mục tiêu lớn thành các bước nhỏ, tự biết khi nào cần tra cứu dữ liệu, tự gọi API/Tools bên ngoài, tự kiểm tra và sửa lỗi khi code bị crash.
AI Agent (Đặc vụ AI) và Hệ thống Đa đặc vụ (Multi-Agent Systems - MAS) chính là sự tiến hóa tất yếu từ "Mô hình ngôn ngữ biết nói" thành "Thực thể phần mềm tự chủ biết hành động" (Autonomous Action-Taking Systems).
2. Các Khái Niệm & Cơ Chế Cốt Lõi
2.1. Cấu Trúc 4 Trụ Cột Của Một Autonomous AI Agent (Lilian Weng Framework)
                       +-----------------------------------+
                       |        BRAIN (LLM Core)           |
                       |    (LLaMA 3, GPT-4, Claude 3.5)   |
                       +-----------------+-----------------+
                                         |
         +-----------------+-------------+-------------+-----------------+
         |                 |                           |                 |
         v                 v                           v                 v
   [1. PLANNING]     [2. MEMORY]                 [3. TOOLS /]      [4. PERCEPTION]
   (Lập kế hoạch)    (Quản lý bộ nhớ)             ACTIONS          (Tiếp nhận input)
   - Phân rã bài toán - Short-term: Context Window - Function Calling - Text / Vision
   - Self-Reflection - Long-term: Vector DB / Graph- Web Search / SQL - Audio / Files
   - Tree-of-Thoughts - Episodic & Semantic Memory - Python REPL Exec
2.2. Khung Tư Duy & Hành Động: ReAct Framework (Yao et al., 2022)
Trước đây, các mô hình chỉ có thể suy nghĩ suông (Chain-of-Thought) hoặc hành động mù quáng (Act-only). ReAct (Reasoning + Acting) kết hợp cả hai thành một vòng lặp tuần tự chặt chẽ:
- Thought (Suy nghĩ): LLM tự độc thoại nội tâm: "Mình cần tìm doanh thu quý 2 của công ty X. Mình sẽ dùng công cụ Google Search."
- Action (Hành động): LLM phát ra lệnh gọi hàm JSON chuẩn:
{"tool": "google_search", "query": "Company X Q2 revenue 2026"}. - Observation (Quan sát): Hệ thống thực thi tool và nạp kết quả trả về vào prompt:
{"result": "$5.2 Billion"}. - Thought tiếp theo: "Đã có số liệu doanh thu. Bây giờ mình cần dùng công cụ Python để tính tốc độ tăng trưởng so với năm ngoái."
2.3. Lập Kế Hoạch & Tự Phản Tư: Tree-of-Thoughts (ToT) & Reflexion
- Chain-of-Thought (CoT): Suy luận tuyến tính 1 chiều. Nếu bước đầu tiên bị sai, toàn bộ các bước sau sụp đổ.
- Tree-of-Thoughts (ToT - Yao et al., 2023): Khám phá không gian giải pháp dưới dạng một Cây tư duy (Search Tree). Mô hình sinh ra nhiều nhánh suy luận song song, sử dụng thuật toán tìm kiếm BFS (Breadth-First Search) hoặc DFS (Depth-First Search) kết hợp với cơ chế tự đánh giá để quay lui (Backtracking) khi gặp nhánh cụt.
- Reflexion Framework (Shinn et al., 2023 - Học tăng cường qua ngôn ngữ):
- Khi Agent thực thi một nhiệm vụ thất bại (ví dụ: code Python sinh ra bị lỗi
IndexError): - Thay vì thử lại mù quáng, Agent kích hoạt một bước Tự phê bình (Self-Reflection): "Tại sao code bị lỗi? Do mình chưa kiểm tra trường hợp mảng rỗng. Lần sau mình cần thêm lệnh
if not arr: return". - Lời tự phê bình này được ghi vào Bộ nhớ ngắn hạn/dài hạn để làm ngữ cảnh cho lần thử tiếp theo Tăng tỷ lệ hoàn thành tác vụ phức tạp từ lên !
- Khi Agent thực thi một nhiệm vụ thất bại (ví dụ: code Python sinh ra bị lỗi
[Khởi tạo Task] ---> [Thực thi Action] ---> [Môi trường trả về LỖI]
                           ^                           |
                           |                           v
                    [Lập kế hoạch mới] <--- [Self-Reflection: Phân tích nguyên nhân lỗi]
2.4. Kiến Trúc Bộ Nhớ Phân Cấp Của Agent (Hierarchical Memory Architecture)
- Working Memory (Bộ nhớ làm việc / Ngắn hạn): Chính là Context Window hiện tại của LLM, lưu trữ lịch sử hội thoại của phiên làm việc.
- Episodic Memory (Bộ nhớ tình huống / Lịch sử kinh nghiệm): Lưu trữ toàn bộ các chuỗi hành động và bài học thành công/thất bại trong quá khứ dưới dạng Vector Embeddings. Khi gặp bài toán tương tự, Agent tra cứu lại để tái sử dụng chiến lược giải quyết.
- Semantic Memory (Bộ nhớ ngữ nghĩa / Tri thức thế giới): Lưu trữ các sự thật cố định, tài liệu nội bộ, Knowledge Graph của doanh nghiệp.
2.5. Hệ Thống Đa Đặc Vụ (Multi-Agent Collaboration Patterns)
Thay vì nhồi nhét mọi công việc cho 1 Agent đơn lẻ (gây loãng prompt và giảm khả năng tập trung), ta xây dựng một đội ngũ các Agent chuyên biệt hóa:
- Supervisor / Router Pattern (Mô hình Quản lý - Phân cấp): Một Agent Trưởng nhận yêu cầu từ người dùng, lập kế hoạch tổng thể và giao việc cho các Worker Agents (ví dụ: Coder Agent, Researcher Agent, Reviewer Agent).
- Peer-to-Peer / Debate Pattern (Mô hình Tranh luận ngang hàng): Hai Agent đóng hai vai trò đối lập (ví dụ: Agent A viết code, Agent B đóng vai trò Hacker cố gắng tìm lỗ hổng bảo mật) tranh luận phản biện lẫn nhau qua nhiều vòng để đạt chất lượng đầu ra tối ưu.
3. Các Bảng Markdown So Sánh Chi Tiết
📊 Bảng 1: So Sánh Traditional RAG vs. Single-Agent vs. Multi-Agent Systems (MAS)
| Tiêu chí | Traditional RAG (Đơn luồng) | Single Autonomous Agent | Multi-Agent Systems (MAS - LangGraph/AutoGen) |
|---|---|---|---|
| Quy trình xử lý | Tuyến tính cố định: Retrieve Generate | Vòng lặp tự chủ: Think Act Observe | Cộng tác phân tán theo vai trò chuyên biệt hóa |
| Khả năng giải quyết bài toán phức tạp | Kém (Chỉ trả lời câu hỏi dựa trên văn bản có sẵn) | Khá (Tự biết gọi Tool nhưng dễ bị lạc đề/lặp vòng vô tận) | Xuất sắc (Chia để trị: Phân tách trách nhiệm rõ ràng) |
| Khả năng tự sửa sai (Self-Correction) | Không có | Có (Qua vòng lặp thử lại cục bộ) | Rất mạnh (Có Agent chuyên trách Audit / Quality Assurance) |
| Kiểm soát Context Window | Dễ quản lý | Dễ bị phình to và loãng ngữ cảnh sau nhiều bước | Rất tối ưu (Mỗi Agent chỉ giữ Context liên quan đến vai trò của nó) |
| Chi phí Token & Thời gian | Thấp nhất | Trung bình | Cao hơn (Do nhiều lượt trao đổi tin nhắn giữa các Agent) |
📊 Bảng 2: So Sánh Các Chiến Lược Lập Kế Hoạch Của LLM (Planning Strategies)
| Chiến lược Planning | Cơ chế thực hiện | Mức độ phức tạp | Khả năng Quay lui (Backtracking) | Use-case tối ưu |
|---|---|---|---|---|
| Chain-of-Thought (CoT) | Sinh chuỗi suy luận từng bước tuyến tính | đường đi | Không thể quay lui | Giải toán đơn giản, suy luận logic 2–3 bước |
| Plan-and-Solve | Lập toàn bộ danh sách các bước trước, sau đó thực thi tuần tự | Kém (Khó thích ứng nếu bước 1 có biến cố) | Tác vụ có quy trình chuẩn định sẵn (SOP) | |
| Tree-of-Thoughts (ToT) | Phân nhánh cây suy luận, đánh giá điểm từng nhánh (BFS/DFS) | Xuất sắc (Tự quay lui khi nhánh cụt) | Chơi cờ, Tối ưu hóa thuật toán phức tạp, Viết lách sáng tạo | |
| Reflexion | Học từ lỗi sai thực tế qua các vòng lặp tự phản tư | Rất tốt qua các phiên chạy | Tự động viết và debug mã nguồn (Code Generation & Repair) |
📊 Bảng 3: So Sánh Các Phương Pháp Đánh Giá Hệ Thống Agent (Evaluation Frameworks)
| Phương pháp đánh giá | Cơ chế thực hiện | Chi phí & Tốc độ | Độ tin cậy & Khách quan | Trọng tâm kiểm tra |
|---|---|---|---|---|
| Human-in-the-Loop Eval | Con người trực tiếp chấm điểm từng bước | Rất đắt, rất chậm | Tiêu chuẩn vàng (Gold Standard) | Đánh giá tổng thể độ hài lòng và tính thực tế |
| LLM-as-a-Judge (G-Eval) | Dùng LLM mạnh (GPT-4) chấm điểm dựa trên Rubric chi tiết | Rẻ, Rất nhanh, Tự động hóa | Khá cao (nếu thiết lập Chain-of-Thought cho Judge) | Độ trung thực (Faithfulness), Mức độ hoàn thành nhiệm vụ |
| Deterministic Unit Tests | Chạy Assertion trên code/API output thực tế | Siêu nhanh, Rẻ | Chính xác tuyệt đối (100%) | Kiểm tra cú pháp JSON, Tính chính xác của kết quả tính toán |
4. Best Practices & Cạm Bẫy Thực Chiến (Pro-Tips & Pitfalls)
💡 Phòng Chống Vòng Lặp Vô Tận (Infinite Loop Prevention) & Timeout
- Cạm bẫy: Agent gọi một Tool bị lỗi Thử lại bằng cách gọi lại đúng Tool đó với tham số tương tự Kẹt vĩnh viễn trong vòng lặp đốt cháy toàn bộ ngân sách API!
- Giải pháp:
- Luôn thiết lập
max_iterations = 10vàmax_execution_time = 60s. - Bắt buộc Agent phải ghi lại lịch sử các lần gọi Tool vào bộ nhớ; nếu phát hiện cùng 1 Tool thất bại 3 lần liên tiếp, ép buộc Agent chuyển sang chiến lược dự phòng (Fallback Strategy) hoặc dừng lại hỏi người dùng.
- Luôn thiết lập
💡 Thiết lập Cơ Chế Kiểm Soát Con Người (Human-in-the-Loop Approval Gates)
Đối với các hành động có mức độ rủi ro cao (Xóa dữ liệu, Gửi email cho khách hàng, Thực hiện giao dịch tài chính), tuyệt đối không để Agent tự ý thực thi:
# Cấu hình ngắt luồng (Interrupt) trong LangGraph:
workflow.add_node("execute_payment", payment_tool)
workflow.add_edge("plan_payment", "human_approval_gate")

# Hệ thống tạm dừng, gửi thông báo xác nhận cho Admin:
# Khi Admin bấm "APPROVED" trên UI -> Workflow mới tiếp tục chạy node "execute_payment"
5. Góc Ôn Luyện Phỏng Vấn (Interview Corner)
❓ Câu hỏi 1: Giải thích cơ chế hoạt động của ReAct (Reasoning + Acting) Framework. Tại sao việc kết hợp giữa Suy luận (Reasoning) và Hành động (Acting) lại giúp giảm thiểu đáng kể hiện tượng Ảo giác (Hallucination) của LLM?
- Gợi ý trả lời:
- Cơ chế hoạt động: ReAct tạo ra một vòng lặp phản hồi tương tác giữa không gian suy luận nội tâm (Thought) và thế giới thực thông qua công cụ (Action & Observation). LLM liên tục cập nhật kế hoạch hành động dựa trên kết quả quan sát thực tế từ môi trường sau mỗi bước.
- Lý do giảm thiểu Ảo giác (Hallucination):
- Khi chỉ có Reasoning (CoT thuần túy): LLM hoàn toàn dựa vào tri thức tĩnh bên trong trọng số mô hình. Khi gặp các sự kiện mới hoặc con số chính xác, mô hình rất dễ tự "bịa" ra thông tin sai lệch để tiếp tục mạch suy luận.
- Khi có Action (ReAct): Thay vì đoán mò, bước suy luận (Thought) nhận thức được giới hạn tri thức và kích hoạt bước hành động (Action) để gọi công cụ tra cứu dữ liệu thực tế (Google Search, SQL Query).
- Kết quả trả về từ môi trường (Observation) đóng vai trò là Điểm tựa sự thật (Grounding Fact) kéo mô hình trở về thực tế, triệt tiêu hoàn toàn ảo giác thông tin.
❓ Câu hỏi 2: Làm thế nào để thiết kế một hệ thống Đánh giá tự động cho AI Agent (Agent Evaluation) bằng phương pháp LLM-as-a-Judge mà không bị thiên vị (Bias)?
- Gợi ý trả lời (Quy trình chuẩn mực 4 bước):
- Định nghĩa Bộ tiêu chí đánh giá rõ ràng (Evaluation Rubric):
- Không hỏi chung chung "Câu trả lời này tốt không?". Phải phân rã thành các tiêu chí định lượng từ 1 đến 5 điểm:
- Task Completion: Đã hoàn thành đúng mục tiêu ban đầu chưa?
- Tool Usage Efficiency: Có gọi thừa thãi các công cụ không cần thiết không?
- Faithfulness: Câu trả lời có bám sát dữ liệu thu thập được từ Tool không?
- Không hỏi chung chung "Câu trả lời này tốt không?". Phải phân rã thành các tiêu chí định lượng từ 1 đến 5 điểm:
- Bắt buộc Mô hình Giám khảo sử dụng Chain-of-Thought (G-Eval Framework):
- Yêu cầu LLM Judge phải viết ra phần phân tích, trích dẫn bằng chứng cụ thể trước khi đưa ra điểm số cuối cùng.
- Khử thiên vị vị trí (Position Bias & Self-Enhancement Bias):
- Hoán đổi vị trí thứ tự câu trả lời của 2 Agent ( và ) khi chấm điểm so sánh (Pairwise Evaluation) và lấy trung bình.
- Sử dụng mô hình giám khảo độc lập từ nhà cung cấp khác (ví dụ: Dùng Claude 3.5 Sonnet để chấm điểm cho Agent chạy GPT-4o) để tránh hiện tượng mô hình tự thiên vị chính mình.
- Định nghĩa Bộ tiêu chí đánh giá rõ ràng (Evaluation Rubric):
❓ Câu hỏi 3: Khi một AI Agent phải xử lý một nhiệm vụ kéo dài qua nhiều giờ với hàng trăm bước tương tác, Context Window của LLM sẽ bị quá tải. Bạn sẽ thiết kế Kiến trúc Quản lý Bộ nhớ (Memory Management) như thế nào để Agent không bị quên mục tiêu ban đầu?
- Gợi ý trả lời (Kiến trúc bộ nhớ 3 tầng):
- Tầng 1 - Cố định Mục tiêu Cốt lõi (Pinned System Prompt / Scratchpad):
- Mục tiêu ban đầu của người dùng, danh sách các ràng buộc và trạng thái tiến độ hiện tại luôn được ghim cố định ở đầu System Prompt, không bao giờ bị xóa.
- Tầng 2 - Tóm tắt Ngữ cảnh Động (Rolling Summarization):
- Khi lịch sử hội thoại vượt quá ngưỡng (ví dụ tokens), kích hoạt một tiến trình nền chạy LLM nhẹ (như GPT-4o-mini / Haiku) để nén toàn bộ 20 bước tương tác cũ thành một đoạn tóm tắt súc tích từ.
- Tầng 3 - Bộ nhớ Tình huống Vector (Episodic Vector Store):
- Toàn bộ chi tiết các kết quả quan sát (Raw Observations, File logs) được đẩy vào một Vector Database cục bộ.
- Khi Agent cần lại thông tin chi tiết của một bước đã thực hiện từ 50 lượt trước, nó chỉ cần thực hiện truy vấn tìm kiếm ngữ nghĩa (Semantic Retrieval) để kéo đúng đoạn dữ liệu đó vào Context mà không làm ô nhiễm bộ nhớ làm việc.
- Tầng 1 - Cố định Mục tiêu Cốt lõi (Pinned System Prompt / Scratchpad):
6. Tóm Tắt Ghi Nhớ Nhanh (Key Takeaways)
- AI Agent = LLM Core (Brain) + Planning + Memory + Tools / Actions.
- ReAct Framework kết hợp vòng lặp Thought Action Observation là nền tảng giúp Agent hành động chính xác và triệt tiêu Hallucination.
- Reflexion cho phép Agent học hỏi từ chính lỗi sai trong quá khứ qua cơ chế Tự phản tư ngôn ngữ (Verbal Self-Reflection).
- Multi-Agent Systems (MAS) giải quyết các bài toán lớn của doanh nghiệp theo nguyên lý Chia để trị (Divide-and-Conquer).
- Luôn thiết lập Human-in-the-Loop Gates cho các hành động nhạy cảm và kiểm soát bộ nhớ qua Rolling Summarization + Vector Episodic Memory.