[Tech Blog #01 | Data Analytics] Thấu Hiểu Dữ Liệu Qua Thống Kê Mô Tả: Mean, Median, Mode & Standard Deviation Thực Chiến
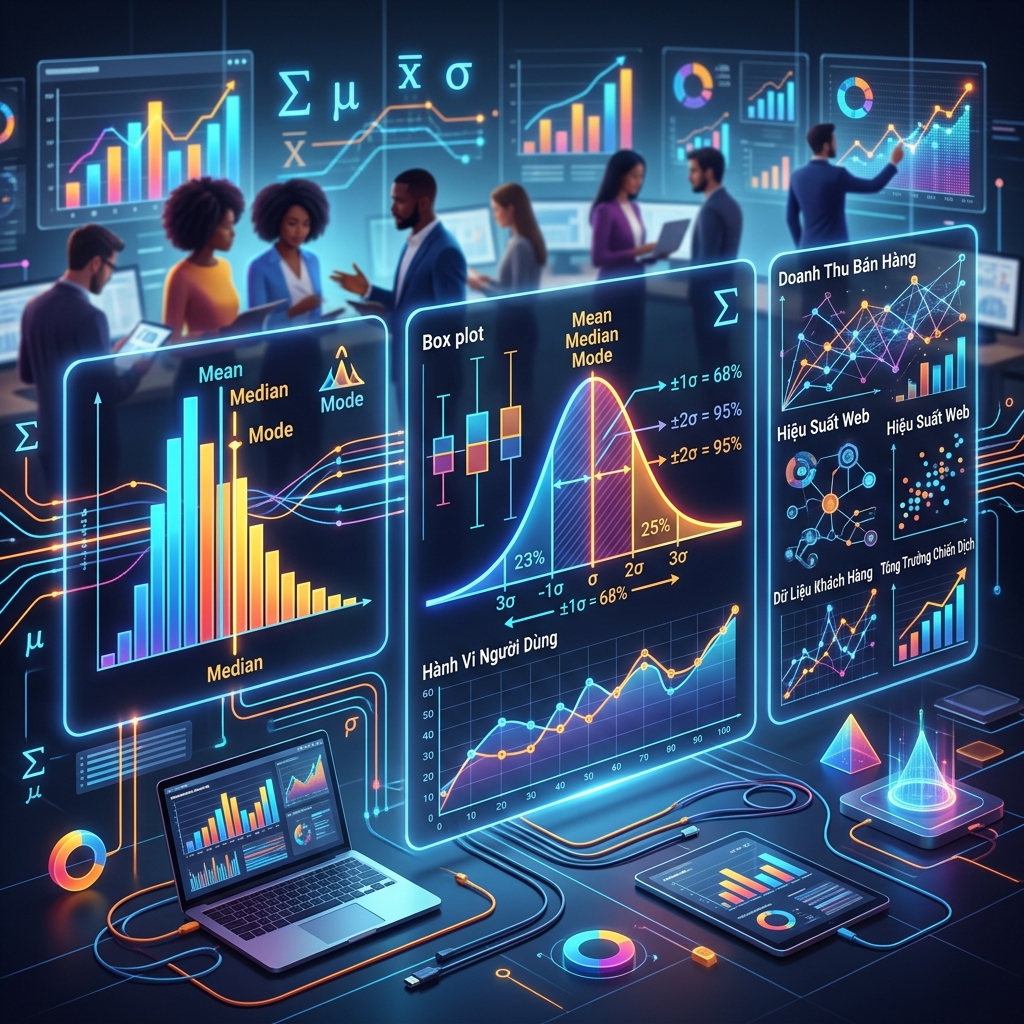
1. Đặt vấn đề: "Bẫy con số trung bình" trong thực tế
Hãy tưởng tượng bạn bước vào một quán cà phê có 10 thực khách, mỗi người có thu nhập khoảng 15 triệu VNĐ/tháng. Đột nhiên, tỷ phú Bill Gates bước vào quán. Nếu tính trung bình cộng thu nhập của 11 người lúc này, con số sẽ vọt lên hàng nghìn tỷ đồng mỗi người.
Về mặt toán học, con số trung bình không hề sai. Nhưng nếu một Data Analyst báo cáo lên ban giám đốc rằng: "Khách hàng ở quán cà phê này có mức thu nhập bình quân hàng nghìn tỷ, hãy mở bán đồ uống siêu cao cấp" thì đó là một quyết định thảm họa.
Đó là lý do tại sao Thống kê mô tả (Descriptive Statistics) là bộ công cụ đầu tiên và quan trọng nhất của người làm dữ liệu. Nó giúp chúng ta tóm tắt, nhìn thấu bản chất của hàng triệu dòng dữ liệu mà không bị đánh lừa bởi các giá trị bất thường (Outliers).
2. Ba thước đo xu hướng tập trung (Measures of Central Tendency)
Khi tiếp cận một cột số liệu (như doanh thu đơn hàng, thời gian phản hồi hỗ trợ, lương nhân viên), câu hỏi đầu tiên luôn là: "Con số nào đại diện tốt nhất cho tập dữ liệu này?"
2.1. Mean (Giá trị trung bình cộng)
- Cách hiểu: Lấy tổng toàn bộ giá trị chia cho số lượng phần tử.
- Ưu điểm: Tận dụng toàn bộ thông tin của mọi điểm dữ liệu, dễ tính toán, trực quan với các tập dữ liệu phân bố đều.
- Nhược điểm lớn nhất: Cực kỳ nhạy cảm với các giá trị đột biến (Outliers) quá cao hoặc quá thấp.
2.2. Median (Trung vị)
- Cách hiểu: Sắp xếp toàn bộ dữ liệu từ bé đến lớn, Median chính là giá trị nằm chính giữa (vị trí 50%).
- Nếu số phần tử lẻ: lấy phần tử ở chính giữa.
- Nếu số phần tử chẵn: lấy trung bình cộng của 2 phần tử ở giữa.
- Ưu điểm: Kháng Outlier cực kỳ tốt. Dù giá trị cao nhất có lớn gấp 1.000 lần thì trung vị vẫn không đổi.
- Ứng dụng thực tế: Đo lường tiền lương, giá bất động sản, thời gian vận chuyển đơn hàng e-commerce (Delivery SLA).
2.3. Mode (Yếu vị)
- Cách hiểu: Giá trị xuất hiện với tần suất nhiều nhất trong tập dữ liệu.
- Ưu điểm: Áp dụng được cho cả biến định lượng lẫn biến định tính (dạng chữ/phân loại).
- Ứng dụng thực tế: Nhập hàng thời trang (size áo/màu sắc bán chạy nhất), kiểm thử chất lượng (mã lỗi xuất hiện nhiều nhất trong ngày).
Bảng so sánh nhanh
| Chỉ số | Kháng ngoại lệ (Outlier)? | Loại dữ liệu phù hợp | Trường hợp ứng dụng kinh doanh tiêu biểu |
|---|---|---|---|
| Mean | ❌ Kém (Bị kéo lệch) | Số liên tục phân phối đối xứng | Doanh thu trung bình theo mùa ổn định, điểm đánh giá trung bình. |
| Median | ✅ Rất tốt | Số liên tục, dữ liệu bị lệch (Skewed) | Thu nhập khách hàng, thời gian load trang web, giá nhà đất. |
| Mode | ✅ Không ảnh hưởng | Số hoặc Phân loại (Categorical) | Xác định khung giờ cao điểm, size sản phẩm bán chạy nhất, lỗi hệ thống phổ biến. |
3. Đo lường độ biến động: Standard Deviation (Độ lệch chuẩn)
Biết giá trị trung bình là chưa đủ. Hãy xem xét ví dụ về 2 tài xế giao đồ ăn (Shipper A và Shipper B):
- Shipper A: Thời gian giao hàng trung bình là 30 phút (các đơn dao động từ 28 – 32 phút).
- Shipper B: Thời gian giao hàng trung bình cũng là 30 phút (nhưng có đơn 10 phút, có đơn 50 phút).
Rõ ràng, Shipper A đem lại trải nghiệm dịch vụ ổn định hơn nhiều. Đại lượng đo lường mức độ "chao đảo" này chính là Standard Deviation ( hoặc ).
Quy tắc thực nghiệm 68 – 95 – 99.7 trong Phân phối chuẩn
Khi dữ liệu có dạng hình chuông đối xứng (Normal Distribution):
- 68% số lượng dữ liệu sẽ nằm trong khoảng độ lệch chuẩn quanh Mean ().
- 95% số lượng dữ liệu sẽ nằm trong khoảng độ lệch chuẩn quanh Mean ().
- 99.7% số lượng dữ liệu sẽ nằm trong khoảng độ lệch chuẩn quanh Mean ().
Mẹo phân tích (Data Hack): Nếu một điểm dữ liệu nằm ngoài ngưỡng trong phân phối gần chuẩn, khả năng cao đó là một ngoại lệ (Outlier) hoặc giao dịch gian lận (Fraud detection) cần được kiểm tra ngay lập tức.
4. Thực hành thực chiến: Python & SQL
Giả sử chúng ta có bảng dữ liệu thời gian giao hàng (phút) của 8 đơn hàng: [15, 20, 22, 25, 26, 28, 30, 95]. Nhận thấy có một đơn hàng bị trễ nghiêm trọng (95 phút).
4.1. Code Python với Pandas & NumPy
import numpy as np
import pandas as pd

# Khởi tạo dữ liệu thời gian giao hàng thực tế
delivery_times = [15, 20, 22, 25, 26, 28, 30, 95]
df = pd.DataFrame({"delivery_time_mins": delivery_times})

# 1. Tính toán các đại lượng xu hướng tập trung
mean_val = df["delivery_time_mins"].mean()  # Trung bình cộng
median_val = df["delivery_time_mins"].median()  # Trung vị
mode_val = df["delivery_time_mins"].mode()[0]  # Yếu vị (lấy giá trị đầu)

# 2. Tính toán độ phân tán
std_val = df["delivery_time_mins"].std()  # Độ lệch chuẩn mẫu (Sample Std)
q1 = df["delivery_time_mins"].quantile(0.25)  # Tứ phân vị thứ nhất (25%)
q3 = df["delivery_time_mins"].quantile(0.75)  # Tứ phân vị thứ ba (75%)
iqr = q3 - q1  # Khoảng tứ phân vị (Interquartile Range)

print(f"Mean (Trung bình): {mean_val:.2f} phút")  # Kết quả: 32.62 phút
print(f"Median (Trung vị): {median_val:.2f} phút")  # Kết quả: 25.50 phút
print(f"Std Dev (Độ lệch chuẩn): {std_val:.2f} phút")  # Kết quả: 25.68 phút

# 3. Tư duy thực hành: Phát hiện Outlier bằng quy tắc IQR
lower_bound = q1 - 1.5 * iqr
upper_bound = q3 + 1.5 * iqr
outliers = df[
    (df["delivery_time_mins"] < lower_bound)
    | (df["delivery_time_mins"] > upper_bound)
]

print(f"Ngưỡng trên phát hiện ngoại lệ: {upper_bound:.2f} phút")
print(f"Các đơn hàng bị coi là bất thường:\n{outliers}")
4.2. Truy vấn SQL phân tích dữ liệu (Chuẩn PostgreSQL / ClickHouse / BigQuery)
-- Truy vấn tính toán thống kê mô tả trực tiếp trong CSDL
SELECT
    COUNT(delivery_time_mins) AS total_orders,

    -- 1. Tính giá trị trung bình (Mean)
    ROUND(AVG(delivery_time_mins), 2) AS mean_delivery_time,

    -- 2. Tính trung vị (Median) bằng hàm PERCENTILE_CONT (tại vị trí 0.5)
    PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY delivery_time_mins) AS median_delivery_time,

    -- 3. Tính độ lệch chuẩn mẫu (Standard Deviation)
    ROUND(STDDEV_SAMP(delivery_time_mins), 2) AS std_delivery_time,

    -- 4. Xác định giá trị nhỏ nhất và lớn nhất
    MIN(delivery_time_mins) AS min_time,
    MAX(delivery_time_mins) AS max_time
FROM
    orders_delivery_log;
5. Câu hỏi phỏng vấn thực tế (Interview Q&A)
Câu 1 (Mức độ: Entry / Junior)
Câu hỏi: "Khi nào bạn quyết định dùng Median thay vì Mean để báo cáo KPI hiệu suất kinh doanh cho Stakeholder?"
Gợi ý trả lời tự tin:
"Em sẽ ưu tiên báo cáo Median khi dữ liệu bị lệch (skewed) mạnh hoặc chứa nhiều giá trị ngoại lệ (outliers) như dữ liệu tiền lương, thời gian giải quyết khiếu nại khách hàng, hoặc giá trị đơn hàng e-commerce. Khi đó, Mean sẽ bị kéo lệch đáng kể về phía ngoại lệ và không phản ánh được trải nghiệm của đa số người dùng. Em cũng sẽ cung cấp thêm cả Mean và Median cùng lúc để giải thích cho Stakeholder thấy sự chênh lệch giữa hai số, từ đó chỉ ra sự tồn tại của nhóm khách hàng hoặc đơn hàng ngoại lệ."
Câu 2 (Mức độ: Junior / Mid-level)
Câu hỏi: "Độ lệch chuẩn (Standard Deviation) cao có ý nghĩa gì đối với chỉ số thời gian phản hồi máy chủ (API Latency)?"
Gợi ý trả lời tự tin:
"Độ lệch chuẩn cao cho thấy thời gian phản hồi của hệ thống đang thiếu ổn định (inconsistency). Dù thời gian phản hồi trung bình (Mean) có thể đạt mục tiêu (ví dụ 200ms), nhưng Std Dev cao chứng tỏ có những request phản hồi rất nhanh và có những request bị nghẽn rất lâu (gây hiện tượng lag giật cục bộ cho người dùng). Để xử lý bài toán này, ngoài Std Dev, em sẽ theo dõi thêm các phân vị như P95 và P99 Latency để đảm bảo 95% đến 99% người dùng nhận được trải nghiệm mượt mà."
6. Key Takeaways (Ghi nhớ nhanh)
- Đừng bao giờ tin tưởng mù quáng vào một con số trung bình (Mean) mà không kiểm tra hình thái phân phối và độ lệch chuẩn.
- Mean phản ánh toàn bộ khối lượng, nhưng Median phản ánh hành vi của số đông.
- Standard Deviation đo lường độ ổn định: Trong kinh doanh và vận hành, độ lệch chuẩn càng nhỏ chứng tỏ quy trình càng được kiểm soát tốt và dễ dự đoán.
- Luôn kết hợp bộ đôi: Khi báo cáo một chỉ số trung tâm, hãy luôn đính kèm một chỉ số đo lường độ phân tán (ví dụ: Mean đi kèm Std Dev, hoặc Median đi kèm IQR / P90).