[AI & DS Blog #34] Kiến Trúc Hệ Thống Gợi Ý Cá Nhân Hóa (Recommendation Systems) Ở Quy Mô Triệu Người Dùng: Mô Hình Hai Tầng (Two-Tower Retrieval & Heavy Ranking DCN/MMoE), Xử Lý Cold-Start & Đánh Giá Offline / Online (NDCG@K)
1 views
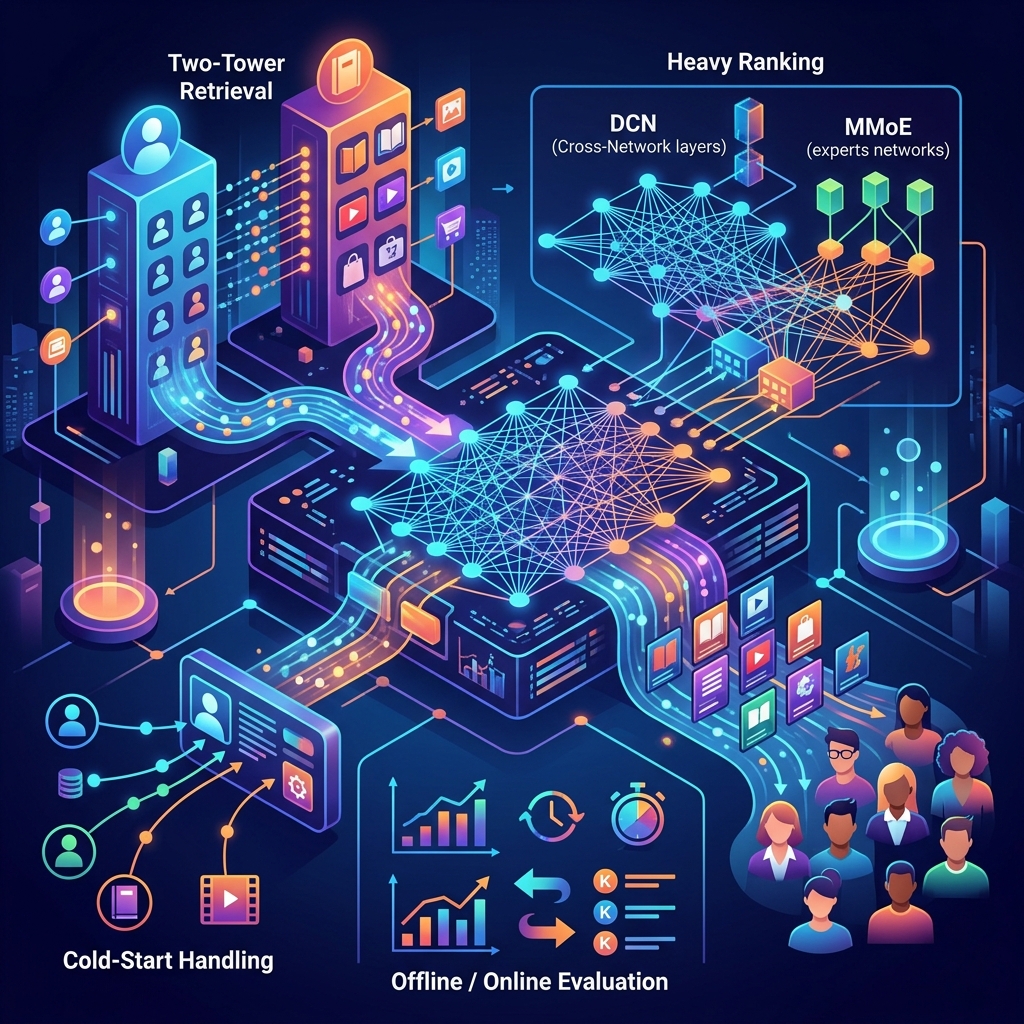
1. Bối cảnh thực tế (Context & Problem Statement)
Trong các nền tảng thương mại điện tử và giải trí số quy mô lớn:
- Kho hàng có hàng chục triệu sản phẩm / video (Items).
- Nền tảng phục vụ hàng trăm triệu người dùng (Users) với sở thích biến đổi liên tục.
- Thời gian phản hồi (Latency SLA): Hệ thống bắt buộc phải chọn ra Top 20 sản phẩm phù hợp nhất cho từng người dùng trong vòng dưới .
Thách thức cốt tử: Bạn không thể đưa sản phẩm vào một mô hình Deep Learning phức tạp để chấm điểm cho từng người dùng trong (bất khả thi về mặt tài nguyên GPU/CPU).
Giải pháp chuẩn mực của ngành là Kiến trúc phân tầng hình phễu (Funnel Architecture / Multi-Stage Pipeline): Chia nhỏ bài toán thành các giai đoạn lọc dần từ thô đến tinh.
2. Các Khái Niệm & Cơ Chế Cốt Lõi
2.1. Phễu Kiến Trúc Hệ Thống Gợi Ý 3 Tầng (The 3-Stage RecSys Pipeline)
[Kho dữ liệu: 10,000,000+ Items]
               |
               v
+-----------------------------------------------------------------------------------+
| TẦNG 1: CANDIDATE GENERATION / RETRIEVAL (Thu hẹp từ 10M -> 1,000 items)         |
|  - Độ trễ: < 10ms                                                                 |
|  - Mục tiêu: Recall cao (Không bỏ sót item tiềm năng), mô hình nhẹ               |
|  - Công nghệ: Two-Tower Neural Network Embeddings + Vector ANN (ScANN / Milvus)  |
+-----------------------------------------------------------------------------------+
               |
               v (1,000 Candidates)
+-----------------------------------------------------------------------------------+
| TẦNG 2: SCORING & HEAVY RANKING (Chấm điểm chi tiết từ 1,000 -> 50 items)        |
|  - Độ trễ: < 30ms                                                                 |
|  - Mục tiêu: Precision & NDCG cao (Dự đoán chính xác pCTR, pCVR)                  |
|  - Công nghệ: Deep & Cross Network (DCN-v2), Multi-gate Mixture-of-Experts (MMoE)|
+-----------------------------------------------------------------------------------+
               |
               v (50 Candidates)
+-----------------------------------------------------------------------------------+
| TẦNG 3: RE-RANKING & BUSINESS RULES (Chọn lọc cuối cùng: Top 10 - 20 items)       |
|  - Độ trễ: < 10ms                                                                 |
|  - Mục tiêu: Đa dạng hóa (Diversity), Loại bỏ trùng lặp (Deduplication), Freshness|
|  - Công nghệ: Maximal Marginal Relevance (MMR), Khám phá Cold-Start (Bandits)    |
+-----------------------------------------------------------------------------------+
               |
               v
[Top 20 Personalized Items hiển thị lên App]
2.2. Tầng 1: Two-Tower Neural Network (Mạng Nơ-ron Hai Tháp)
Được Google giới thiệu để giải quyết bài toán Retrieval quy mô lớn:
- User Tower (Tháp Người Dùng): Nhận đầu vào là các đặc trưng của user (
user_id, độ tuổi, giới tính, lịch sử 50 video đã xem gần nhất, thiết bị, thời gian) Nén thành một vector nhúng (ví dụ ). - Item Tower (Tháp Vật Phẩm): Nhận đầu vào là các đặc trưng của sản phẩm (
item_id, danh mục, tác giả, mô tả văn bản, thẻ tags) Nén thành một vector nhúng . - Độ tương đồng (Score): Tính bằng tích vô hướng giữa 2 vector:
- Bí quyết phục vụ thời gian thực ():
- Hàng triệu vector Item được tính toán trước Offline (Pre-computed) và nạp vào một Vector Database (ANN Search như HNSW / ScANN).
- Khi user mở app, hệ thống chỉ cần chạy duy nhất User Tower trên GPU để tạo vector (), sau đó gọi Vector Search để lấy ra item gần nhất trong vài mili-giây!
[User Features] ---> [USER TOWER (MLP)] ---> Vector u (128-d)
                                                    \
                                                  Dot-Product <u, v> ---> Top 1,000 Candidates
                                                    /
[Item Features] ---> [ITEM TOWER (MLP)] ---> Vector v (Pre-computed in Vector DB)
2.3. Tầng 2: Heavy Ranking & Mô Hình Học Đa Nhiệm (MMoE)
Tại tầng Ranking, ta cần dự đoán nhiều hành vi cùng lúc: Khách hàng có Click không () VÀ có Mua hàng không () VÀ có Đánh giá 5 sao không?
- Vấn đề của mô hình đơn nhiệm: Dự đoán CTR cao chưa chắc user đã mua (Clickbait).
- Multi-gate Mixture-of-Experts (MMoE - Google):
- Sử dụng mạng nơ-ron chuyên gia độc lập (Shared Expert Sub-networks).
- Mỗi tác vụ mục tiêu (Task 1: Click, Task 2: Purchase) có một Cổng điều phối riêng (Gating Network) để tự động học cách lấy tổ hợp trọng số từ các chuyên gia khác nhau.
- Giải quyết triệt để xung đột mục tiêu (Negative Transfer) giữa các hành vi người dùng.
2.4. Các Chỉ Số Đánh Giá Xếp Hạng Ngoại Tuyến (Offline Ranking Metrics)
Làm thế nào để biết thuật toán Ranking A xếp hạng tốt hơn thuật toán B trên tập dữ liệu lịch sử?
- Cumulative Gain (CG) & Discounted Cumulative Gain (DCG@K):
- Đánh giá mức độ liên quan () của các item trong Top , áp dụng hệ số phạt giảm dần theo logarit của vị trí hiển thị (Vật phẩm liên quan cao đứng ở vị trí đầu tiên sẽ được nhiều điểm hơn):
- Normalized Discounted Cumulative Gain (NDCG@K - Chuẩn mực số 1):
- Chuẩn hóa DCG@K về dải bằng cách chia cho giá trị DCG lý tưởng nhất có thể đạt được (IDCG@K - khi toàn bộ các item có điểm liên quan cao nhất được xếp lên đầu):
- Mean Reciprocal Rank (MRR): Đo vị trí xuất hiện của item liên quan đầu tiên: .
3. Các Bảng Markdown So Sánh Chi Tiết
📊 Bảng 1: So Sánh Toàn Diện Các Tầng Trong Hệ Thống Gợi Ý
| Tiêu chí | Tầng 1: Retrieval (Candidate Generation) | Tầng 2: Scoring & Heavy Ranking | Tầng 3: Re-Ranking & Business Rules |
|---|---|---|---|
| Quy mô đầu vào | items | ||
| Quy mô đầu ra | Top | ||
| Độ phức tạp mô hình | Đơn giản, tính toán độc lập () | Rất phức tạp (Deep Cross, MMoE, tương tác chéo thuộc tính) | Thuật toán tối ưu hóa quy tắc, Đa dạng hóa (MMR) |
| Đặc trưng sử dụng (Features) | Chỉ dùng đặc trưng tĩnh hoặc lịch sử dài hạn | Kết hợp toàn bộ đặc trưng thời gian thực, ngữ cảnh tương tác | Vị trí hiển thị, Danh mục trùng lặp, Cờ tài trợ (Ads) |
| Độ trễ mục tiêu (SLA) |
📊 Bảng 2: So Sánh Matrix Factorization vs. Two-Tower vs. Graph Collaborative Filtering
| Phương pháp | Cơ chế biểu diễn | Khả năng sử dụng thêm thuộc tính (Side Features) | Xử lý Cold-Start | Khả năng Scale hàng tỷ items |
|---|---|---|---|---|
| Matrix Factorization (SVD / ALS) | Phân rã ma trận tương tác User-Item thành | Rất kém (Chỉ dùng ID người dùng và ID sản phẩm) | Thất bại hoàn toàn khi gặp user/item mới | Rất tốt |
| Two-Tower Neural Networks | Ánh xạ phi tuyến qua Deep Neural Networks | Xuất sắc (Nhận hàng trăm biến số text, category, context) | Rất tốt (Chỉ cần thuộc tính của item để sinh vector) | Chuẩn mực công nghiệp hiện nay |
| Graph Neural Networks (PinSage / LightGCN) | Lan tỏa embedding qua đồ thị liên kết đa tầng | Rất tốt (Khai thác cấu trúc mạng lưới quan hệ) | Khá | Tốn tài nguyên tính toán lúc huấn luyện |
📊 Bảng 3: So Sánh Các Thước Đo Đánh Giá Ranking Offline
| Metric | Bản chất đo lường | Độ nhạy với vị trí (Position-sensitive) | Thích hợp cho loại bài toán |
|---|---|---|---|
| NDCG@K | Đo mức độ liên quan đa cấp () có chiết khấu theo vị trí | Rất cao (Thưởng lớn cho vị trí đầu bảng) | E-commerce, Tìm kiếm thông tin, Video Streaming (Chuẩn phỏng vấn) |
| MAP@K (Mean Average Precision) | Đo độ chính xác trên nhãn nhị phân ( hoặc ) | Cao | Bài toán có nhiều item đúng (Binary relevance) |
| MRR (Mean Reciprocal Rank) | Chỉ đo vị trí của vật phẩm đúng đầu tiên | Cực cao (Bỏ qua các vị trí đúng phía sau) | Gợi ý tìm kiếm nhanh (Search Autocomplete), Trả lời câu hỏi QA |
| Hit Rate@K (HR@K) | Tỷ lệ phiên có ít nhất 1 item được chọn trong Top | Không phân biệt thứ hạng trong Top | Đánh giá tổng quan tầng Retrieval (Candidate Generation) |
4. Best Practices & Giải Pháp Xử Lý Cold-Start Thực Chiến (Pro-Tips)
💡 Chiến Lược Giải Quyết Vấn Đề Người Dùng / Sản Phẩm Mới (Cold-Start Problem)
- User Cold-Start (Người dùng mới chưa có lịch sử tương tác):
- Khai thác đặc trưng bối cảnh (Contextual Features): Vị trí địa lý (GeoIP), Thiết bị (iOS/Android), Nguồn tải app (Marketing Campaign).
- Hiển thị bảng khảo sát sở thích lúc Onboarding hoặc gợi ý các sản phẩm thịnh hành nhất (Popularity-based Fallback).
- Item Cold-Start (Sản phẩm mới đăng chưa có lượt click/mua):
- Tận dụng Item Tower trong mô hình Two-Tower: Sử dụng hình ảnh (qua CNN/ViT) và mô tả văn bản (qua Text Embeddings) để sinh vector cho sản phẩm mới ngay lập tức mà không cần chờ tương tác người dùng.
- Cơ chế Khám phá (Exploration via Multi-Armed Bandits / LinUCB): Trích xuất một tỷ lệ lưu lượng nhỏ () để chủ động hiển thị các sản phẩm mới nhằm thu thập dữ liệu phản hồi ban đầu.
💡 Khắc Phục Thiên Vị Vị Trí Hiển Thị (Position Bias Correction)
- Vấn đề: Người dùng luôn có xu hướng bấm vào sản phẩm ở vị trí Top 1 dù nó không phải là sản phẩm tốt nhất. Nếu đưa trực tiếp dữ liệu này vào huấn luyện, mô hình sẽ bị thiên lệch nghiêm trọng.
- Giải pháp Inverse Propensity Scoring (IPS):
- Gán trọng số nghịch đảo cho mỗi lượt click dựa trên xác suất được nhìn thấy của vị trí :
- Huấn luyện mô hình với các mẫu ở vị trí dưới thấp có trọng số cao hơn để bù đắp thiệt thòi về độ hiển thị.
5. Góc Ôn Luyện Phỏng Vấn (Interview Corner)
❓ Câu hỏi 1: Tại sao các hệ thống Recommendation System hiện đại đều phân tách thành kiến trúc Two-Stage (Retrieval và Ranking) thay vì dùng 1 mô hình duy nhất?
- Gợi ý trả lời:
- Sự đánh đổi giữa Không gian Tìm kiếm và Độ phức tạp Tính toán:
- Kho dữ liệu có quy mô hàng chục triệu sản phẩm. Một mô hình Ranking phức tạp (với hàng trăm lớp nơ-ron và tương tác chéo đặc trưng) mất khoảng để chấm điểm 100 sản phẩm. Nếu chấm điểm toàn bộ 10 triệu sản phẩm, thời gian tính toán sẽ mất hàng trăm giây Vi phạm hoàn toàn SLA độ trễ ().
- Sự phân công chuyên biệt:
- Tầng Retrieval (Two-Tower / Vector Search): Hy sinh một phần độ chính xác chi tiết để đổi lấy tốc độ quét hàng triệu sản phẩm trong nhờ tính toán vector dot-product trên phần cứng tối ưu (ANN Search). Nhiệm vụ là đảm bảo Recall cao (không bỏ sót).
- Tầng Ranking (MMoE / DCN): Chỉ phải tính toán trên tập nhỏ ứng viên đã được lọc sẵn, cho phép áp dụng toàn bộ các đặc trưng thời gian thực phức tạp nhất để tối đa hóa Precision và NDCG (chấm điểm chính xác).
- Sự đánh đổi giữa Không gian Tìm kiếm và Độ phức tạp Tính toán:
❓ Câu hỏi 2: Giải thích nguyên lý hoạt động của mô hình Two-Tower Neural Network. Làm thế nào nó cho phép tính toán độ tương đồng giữa User và Item trong thời gian trên tập 10 triệu sản phẩm?
- Gợi ý trả lời:
- Cơ chế tách rời (Decoupled Architecture):
- Mô hình chia thành 2 tháp mạng nơ-ron độc lập: Tháp User nhận đầu vào là thông tin người dùng sinh ra vector ; Tháp Item nhận thông tin sản phẩm sinh ra vector .
- Điểm số dự đoán là tích vô hướng .
- Bí quyết đạt tốc độ :
- Tính toán ngoại tuyến (Offline Pre-computation): Vì thông tin sản phẩm không thay đổi liên tục theo từng mili-giây, toàn bộ 10 triệu vector Item được tính toán trước định kỳ và đưa vào cấu trúc chỉ mục tìm kiếm vector xấp xỉ (HNSW / ScANN Index).
- Tính toán trực tuyến tối thiểu (Online Lightweight Inference): Khi user gửi request, hệ thống chỉ chạy Tháp User đúng 1 lần duy nhất để tạo vector .
- Vector Nearest Neighbor Search: Thực hiện phép tìm kiếm -Nearest Neighbors giữa vector và chỉ mục Item vector trong RAM Trả về 1,000 sản phẩm có khoảng cách gần nhất trong vòng mà không cần chạy lại mô hình cho 10 triệu sản phẩm!
- Cơ chế tách rời (Decoupled Architecture):
❓ Câu hỏi 3: Chỉ số NDCG@K được tính toán như thế nào? Tại sao NDCG@K lại là thước đo chuẩn mực nhất để đánh giá chất lượng mô hình Ranking trong E-commerce và Video Streaming?
- Gợi ý trả lời:
- Cách tính toán:
- Tính , trong đó là mức độ liên quan của sản phẩm ở vị trí (ví dụ: , , , ).
- Sắp xếp các sản phẩm theo thứ tự điểm giảm dần lý tưởng nhất và tính (Ideal DCG).
- Lấy tỷ số: .
- Lý do là thước đo chuẩn mực số 1:
- Phản ánh giá trị mức độ liên quan đa cấp (Graded Relevance): Không chỉ đánh giá nhị phân , NDCG cho phép gán trọng số lớn hơn nhiều cho hành vi mua hàng () so với chỉ click xem ().
- Chiết khấu theo vị trí tâm lý học (Logarithmic Position Discount): Người dùng có xu hướng chú ý nhiều nhất vào các vị trí đầu tiên. Phép chia cho phạt rất nặng nếu mô hình xếp một sản phẩm xuất sắc ở vị trí số 10 thay vì vị trí số 1.
- Khả năng so sánh chuẩn hóa: Nhờ việc chia cho IDCG, điểm số luôn nằm trong đoạn , cho phép so sánh công bằng hiệu năng mô hình giữa các truy vấn có số lượng sản phẩm liên quan khác nhau.
- Cách tính toán:
6. Tóm Tắt Ghi Nhớ Nhanh (Key Takeaways)
- Hệ thống RecSys hiện đại bắt buộc phải thiết kế theo Phễu 3 tầng: Retrieval () Heavy Ranking () Re-Ranking (Top ).
- Two-Tower Neural Network là nền tảng của tầng Retrieval nhờ khả năng Pre-compute Item Embeddings và tra cứu vector ANN siêu tốc ().
- MMoE (Multi-gate Mixture-of-Experts) giải quyết bài toán tối ưu hóa đồng thời nhiều mục tiêu kinh doanh (Click, Like, Share, Purchase).
- NDCG@K là chỉ số vàng đánh giá chất lượng xếp hạng Offline nhờ kết hợp giữa Mức độ liên quan đa cấp và Chiết khấu vị trí hiển thị.
- Xử lý Cold-Start bằng cách khai thác đặc trưng nội dung (Content-based Embeddings) kết hợp chiến lược Multi-Armed Bandits.
0Claps