[DS & MLOps Blog #31] Hệ Thống MLOps Thực Chiến & Giám Sát Mô Hình Học Máy: Phát Hiện Data Drift, Concept Drift, Chỉ Số PSI / KS-Test & Chiến Lược Triển Khai Model Serving (Shadow, Canary, Blue-Green)
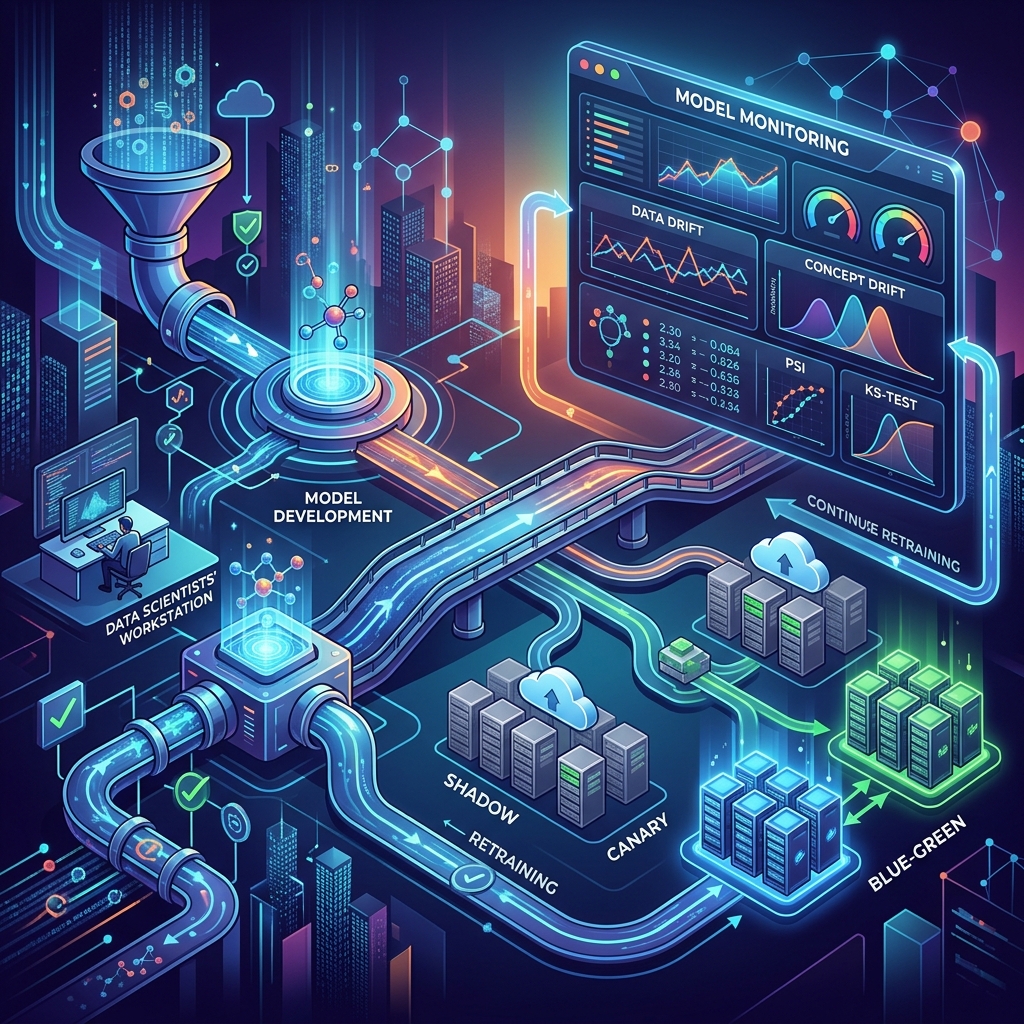
1. Bối cảnh thực tế (Context & Problem Statement)
Huấn luyện một mô hình Machine Learning đạt độ chính xác trên Jupyter Notebook chỉ chiếm khối lượng công việc của một dự án AI thực tế (theo bài báo kinh điển của Google: "Hidden Technical Debt in Machine Learning Systems").
thử thách còn lại nằm ở giai đoạn Vận hành và Giám sát trên Production (MLOps):
- Ngay tại thời điểm bạn bấm nút Deploy, chất lượng mô hình sẽ bắt đầu suy thoái theo thời gian (Model Degradation) do hành vi người dùng, điều kiện kinh tế và môi trường thực tế liên tục biến đổi.
- Trong đại dịch COVID-19 hoặc các đợt lạm phát kinh tế, các mô hình dự báo nhu cầu chuỗi cung ứng hay chấm điểm rủi ro tín dụng của hàng loạt ngân hàng lớn đồng loạt bị "mất phương hướng" vì dữ liệu thực tế không còn giống với dữ liệu trong quá khứ lúc train.
Để duy trì độ tin cậy của hệ thống AI, kỹ sư dữ liệu và nhà khoa học dữ liệu bắt buộc phải thiết lập hệ thống Phát hiện suy thoái dữ liệu (Drift Detection) và Quy trình tái huấn luyện tự động (Continuous Retraining Pipeline).
2. Các Khái Niệm & Cơ Chế Cốt Lõi
2.1. Phân Biệt Các Loại Suy Thoái Mô Hình (Drift Types)
Mối quan hệ xác suất trong học máy có giám sát được mô tả qua phân phối đồng thời: (trong đó là tập biến đầu vào Features, là biến mục tiêu Ground Truth Label).
+-----------------------------------------------------------------------------------+
| 1. COVARIATE SHIFT / DATA DRIFT:                                                  |
|    - P(X) thay đổi, nhưng P(Y|X) KHÔNG đổi.                                       |
|    - Ví dụ: Ứng dụng mở rộng tệp khách hàng sang nhóm người lớn tuổi (> 60 tuổi).  |
|      Phân phối tuổi thay đổi, nhưng cùng một độ tuổi thì hành vi chi tiêu vẫn vậy.|
+-----------------------------------------------------------------------------------+
| 2. CONCEPT DRIFT:                                                                 |
|    - P(Y|X) thay đổi, trong khi P(X) có thể KHÔNG đổi.                            |
|    - Ví dụ: Lạm phát làm giá trị $100 mua được ít đồ hơn; hoặc tội phạm thay đổi |
|      thủ đoạn lừa đảo tinh vi hơn (Cùng thuộc tính X nhưng kết quả Y đảo ngược).  |
+-----------------------------------------------------------------------------------+
| 3. PRIOR PROBABILITY / LABEL DRIFT:                                               |
|    - P(Y) thay đổi (Tỷ lệ phân bố lớp mục tiêu trong thực tế bị biến động).      |
|    - Ví dụ: Tỷ lệ thất nghiệp toàn quốc tăng vọt trong mùa dịch.                  |
+-----------------------------------------------------------------------------------+
2.2. Các Phương Pháp Toán Học Phát Hiện Data Drift
Làm thế nào để biết phân phối của dữ liệu ngày hôm nay trên Production () đã bị lệch so với dữ liệu lúc Train ()?
- Population Stability Index (PSI - Chuẩn mực ngành Ngân hàng / FinTech):
- Chia biến số thành khoảng (Buckets/Quantiles, thường là 10 bins).
- Tính toán tỷ lệ phần trăm dữ liệu rơi vào từng bin lúc Train () và lúc Production ():
- Ngưỡng hành động chuẩn quốc tế:
- : Phân phối ổn định Không cần làm gì.
- : Có sự biến động nhẹ Cần theo dõi sát sao.
- : Dữ liệu bị biến động nghiêm trọng (Significant Drift) Bắt buộc kích hoạt Retrain mô hình ngay lập tức!
- Kolmogorov-Smirnov Test (KS-Test - Cho biến liên tục):
- Phép kiểm định phi tham số đo lường khoảng cách lớn nhất giữa 2 hàm phân phối tích lũy (CDF):
- Nếu giá trị , ta kết luận phân phối của thuộc tính đó đã bị thay đổi có ý nghĩa thống kê.
- Chi-Square () Goodness of Fit Test: Dùng để phát hiện drift trên các biến phân loại (Categorical Features).
2.3. Các Chiến Lược Triển Khai Mô Hình (Model Serving Strategies)
Khi cập nhật Model v2 thay thế Model v1 đang chạy trên Production:
SHADOW DEPLOYMENT (Dark Launching):
[Client Traffic (100%)] ---> [Model v1 (Active)] ---> Trả kết quả cho User
                         ---> [Model v2 (Shadow)] ---> Lưu log ngầm để so sánh (Zero Risk)

CANARY DEPLOYMENT:
[Client Traffic] ---> 90% Traffic ---> [Model v1]
                 ---> 10% Traffic ---> [Model v2] (Tăng dần lên 50% -> 100% nếu ổn định)

BLUE-GREEN DEPLOYMENT:
[Router / Load Balancer] ---> [Blue Environment (Model v1 - Live)]
                              [Green Environment (Model v2 - Idle/Ready)]
                              (Đổi Router sang Green trong 1 giây qua DNS/LB Switch)
3. Các Bảng Markdown So Sánh Chi Tiết
📊 Bảng 1: So Sánh Toàn Diện Các Loại Suy Thoái Mô Hình (Model Drifts)
| Loại Drift | Biểu thức xác suất thay đổi | Nguyên nhân gốc rễ trong thực tế | Tác động lên mô hình | Phương pháp phát hiện |
|---|---|---|---|---|
| Data Drift (Covariate Shift) | thay đổi, cố định | Chiến dịch Marketing thu hút tệp khách mới; camera bị mờ làm ảnh hưởng độ sáng ảnh | Mô hình phải ngoại suy trên vùng dữ liệu chưa từng thấy | PSI, KS-Test, Wasserstein Distance, Evidently AI |
| Concept Drift | thay đổi, cố định | Quy luật thị trường thay đổi, hành vi gian lận tiến hóa, đối thủ cạnh tranh giảm giá | Mô hình dự đoán sai hoàn toàn (Độ chính xác sụt giảm nghiêm trọng) | Đo lường độ giảm Performance (F1/AUC) khi có nhãn thực tế |
| Label Drift | thay đổi | Sự kiện ngoại cảnh vĩ mô (Khủng hoảng kinh tế, Dịch bệnh, Mùa vụ lễ hội) | Phân phối xác suất đầu ra của mô hình bị lệch pha | So sánh phân phối xác suất dự đoán theo thời gian |
📊 Bảng 2: So Sánh Các Chiến Lược Triển Khai Mô Hình (Deployment Strategies)
| Chiến lược | Mức độ rủi ro kinh doanh | Chi phí hạ tầng | Thời gian Rollback | Đánh giá trải nghiệm thực tế |
|---|---|---|---|---|
| Shadow (Dark Launch) | Bằng 0 (Zero Risk) | Cao ( Compute do chạy song song 2 model) | Không cần rollback (Không ảnh hưởng user) | Đánh giá được độ trễ thực tế và lỗi ngầm mà không gây hại |
| Canary Release | Rất thấp (Chỉ ảnh hưởng tệp nhỏ user) | Trung bình (Tăng dần tài nguyên) | Rất nhanh (Chuyển ngược traffic về v1) | Kiểm tra trực tiếp độ hài lòng của người dùng thực tế |
| Blue-Green Deployment | Thấp | Cao ( hạ tầng hoàn chỉnh) | Gần như tức thì (Instant Switch) | Kiểm tra toàn diện trên môi trường Green trước khi gạt công tắc |
| A/B Testing | Thấp | Trung bình | Nhanh | Đo lường chính xác tác động kinh doanh (Business Uplift) |
📊 Bảng 3: So Sánh Các Thước Đo Phát Hiện Dữ Liệu Lệch Pha (Drift Metrics)
| Thước đo | Loại dữ liệu áp dụng | Bản chất thuật toán | Ngưỡng cảnh báo điển hình | Điểm mạnh cốt lõi |
|---|---|---|---|---|
| PSI (Population Stability Index) | Số thực & Phân loại (đã binning) | Dựa trên Entropy / KL-Divergence đối xứng | (Cảnh báo), (Hành động) | Tiêu chuẩn công nghiệp rõ ràng, dễ giải thích cho ban giám đốc |
| KS-Test (Kolmogorov-Smirnov) | Số thực liên tục | Đo khoảng cách lớn nhất giữa 2 đường cong tích lũy | Không cần chia bin dữ liệu, độc lập với thang đo | |
| Jensen-Shannon (JS) Divergence | Bất kỳ phân phối xác suất nào | Dạng mượt hóa đối xứng của KL Divergence | Dải giá trị (Ngưỡng ) | Không bị lỗi chia cho 0 khi có xác suất bằng 0 |
| Chi-Square () Test | Biến phân loại (Categorical) | So sánh tần số quan sát vs. tần số kỳ vọng | Rất mạnh trên các biến danh mục nhiều nhóm |
4. Best Practices & Kỹ Thuật Tự Động Hóa MLOps (Pro-Tips)
💡 Triển khai Tính toán PSI Bằng Python / Pandas
import numpy as np
import pandas as pd

def calculate_psi(baseline: pd.Series, actual: pd.Series, num_buckets: int = 10) -> float:
    # 1. Chia mốc phân vị (Quantile Bins) dựa trên tập dữ liệu chuẩn (Baseline/Train):
    quantiles = np.linspace(0, 100, num_buckets + 1)
    bins = np.percentile(baseline.dropna(), quantiles)
    bins[0] = -np.inf
    bins[-1] = np.inf

    # 2. Đếm số lượng mẫu trong từng bin:
    baseline_counts = pd.cut(baseline, bins=bins).value_counts(sort=False)
    actual_counts = pd.cut(actual, bins=bins).value_counts(sort=False)

    # 3. Tính tỷ lệ % (thêm epsilon 1e-4 để tránh lỗi chia cho 0):
    A_pct = (baseline_counts / len(baseline)) + 1e-4
    E_pct = (actual_counts / len(actual)) + 1e-4

    # 4. Áp dụng công thức PSI:
    psi_value = np.sum((A_pct - E_pct) * np.log(A_pct / E_pct))
    return round(float(psi_value), 4)

# Ví dụ áp dụng:
# psi_score = calculate_psi(df_train['income'], df_prod_today['income'])
# if psi_score >= 0.2: trigger_retrain_pipeline()
💡 Chiến lược Tự Động Hóa Retraining Pipeline (Continuous Training - CT)
- Không kích hoạt Retrain mù quáng: Tránh việc mỗi khi có 1 batch dữ liệu lỗi hoặc drift tạm thời trong 1 ngày đã kích hoạt retrain ngay (lãng phí GPU và dễ làm mô hình học theo nhiễu ngắn hạn).
- Quy trình chuẩn mực (Two-Step Retraining Gate):
- Bước 1 (Drift Alert): Khi PSI liên tục trong 3 ngày Kích hoạt Airflow DAG lấy dữ liệu 30 ngày gần nhất để Train ra Model Candidate mới.
- Bước 2 (Validation Gate): Chạy Model Candidate trên tập kiểm thử ẩn. Chỉ khi các chỉ số cốt lõi (PR-AUC / F1) vượt trội hơn Model đang chạy trên Production ít nhất , hệ thống mới tự động đẩy sang giai đoạn Canary Deployment.
5. Góc Ôn Luyện Phỏng Vấn (Interview Corner)
❓ Câu hỏi 1: Giải thích sự khác biệt cốt lõi giữa Data Drift (Covariate Shift) và Concept Drift. Hãy nêu một ví dụ thực tế trong bài toán Phát hiện Giao dịch Gian lận (Fraud Detection) và giải thích tại sao Concept Drift lại nguy hiểm hơn nhiều.
- Gợi ý trả lời:
- Sự khác biệt bản chất:
- Data Drift: Phân phối đầu vào thay đổi nhưng mối quan hệ logic giữa và () không đổi.
- Concept Drift: Mối quan hệ logic bị thay đổi; cùng một tập giá trị đầu vào nhưng nhãn thực tế trong đời thực đã bị đảo lộn.
- Ví dụ trong Fraud Detection:
- Data Drift: Ngân hàng ra mắt chương trình khuyến mãi thẻ tín dụng cho sinh viên Phân phối độ tuổi và số dư tài khoản dịch chuyển mạnh sang nhóm trẻ tuổi và số dư thấp, nhưng các hành vi quẹt thẻ đáng ngờ (ví dụ: giao dịch liên tiếp ở 2 quốc gia) vẫn tuân theo quy luật cũ.
- Concept Drift: Các đối tượng tội phạm công nghệ cao đổi thủ đoạn mới: Chúng không còn rút tiền vào lúc nửa đêm với số tiền lớn nữa, mà chia nhỏ thành hàng trăm giao dịch vi mô \1\rightarrowXY = 1$ (Gian lận).
- Tại sao Concept Drift nguy hiểm hơn:
- Data Drift có thể dễ dàng phát hiện ngay lập tức bằng các kiểm định thống kê trên dữ liệu đầu vào () mà không cần biết nhãn thật.
- Concept Drift thường diễn ra âm thầm, chỉ có thể phát hiện khi nhãn thực tế () được ghi nhận (thường có độ trễ vài tuần khi khách hàng khiếu nại bị mất tiền), gây ra thiệt hại tài chính nặng nề trước khi hệ thống kịp nhận biết.
- Sự khác biệt bản chất:
❓ Câu hỏi 2: Chỉ số Population Stability Index (PSI) là gì? Hãy trình bày ý nghĩa của từng thành phần trong công thức toán học và các ngưỡng hành động tiêu chuẩn trong môi trường doanh nghiệp.
- Gợi ý trả lời:
- Định nghĩa: PSI là chỉ số đo lường mức độ biến động phân phối của một biến số giữa hai tập dữ liệu (Tập chuẩn Baseline/Train và Tập thực tế Production).
- Ý nghĩa thành phần công thức:
- Nếu ở bin , tỷ lệ thực tế lớn hơn kỳ vọng , thì cả và đều mang dấu dương Tích số luôn .
- Sự kết hợp giữa độ chênh lệch tuyệt đối và tỷ số logarit giúp triệt tiêu nhiễu ở những bin có số lượng mẫu quá nhỏ nhưng lại phóng đại mức phạt ở những bin có sự dịch chuyển tỷ trọng lớn.
- Ngưỡng hành động chuẩn công nghiệp:
- : Green (An toàn) – Dữ liệu ổn định, mô hình hoạt động bình thường.
- : Yellow (Cảnh báo) – Có sự dịch chuyển nhỏ, đội ngũ MLOps bắt đầu kiểm tra nguyên nhân từ nguồn dữ liệu.
- : Red (Nguy hiểm) – Dữ liệu đã thay đổi cấu trúc hoàn toàn, bắt buộc phải kích hoạt quy trình Tái huấn luyện mô hình (Retrain Pipeline).
❓ Câu hỏi 3: Khi triển khai một mô hình Machine Learning mới thay thế mô hình cũ trên Production, bạn sẽ thiết kế chiến lược kết hợp giữa Shadow Deployment và Canary Release như thế nào để đảm bảo rủi ro bằng 0 (Zero Downtime & Zero Risk)?
- Gợi ý trả lời theo quy trình 3 giai đoạn:
- Giai đoạn 1 - Shadow Deployment (Dark Launching) trong 7 ngày:
- API Gateway nhân bản (Duplicate/Mirror) request thực tế gửi đồng thời tới cả Model v1 (Live) và Model v2 (Shadow).
- Chỉ có kết quả của Model v1 được trả về cho người dùng.
- Kết quả dự đoán và độ trễ của Model v2 được lưu ngầm vào Database để:
- Đo lường độ trễ thực tế ( Latency) và mức chiếm dụng CPU/RAM của Model v2.
- So sánh độ tương đồng trong quyết định giữa v1 và v2 (Prediction Divergence Rate).
- Giai đoạn 2 - Canary Release tăng dần (Gradual Traffic Shifting):
- Nếu Giai đoạn 1 an toàn, bắt đầu định tuyến lưu lượng người dùng thực sự nhận kết quả từ Model v2, trong khi còn lại vẫn dùng Model v1.
- Theo dõi sát sao các chỉ số kinh doanh (Conversion Rate, Tỷ lệ khiếu nại, Error Rate) trên nhóm này.
- Nếu mọi chỉ số ổn định, tăng dần tỷ lệ lên trong suốt 48 giờ.
- Giai đoạn 3 - Automated Rollback Trigger (Cầu dao tự động):
- Thiết lập cảnh báo tự động: Nếu tỷ lệ lỗi HTTP hoặc độ trễ phản hồi tại bất kỳ thời điểm nào trong giai đoạn Canary, hệ thống tự động gạt lưu lượng trở lại Model v1 trong vòng .
- Giai đoạn 1 - Shadow Deployment (Dark Launching) trong 7 ngày:
6. Tóm Tắt Ghi Nhớ Nhanh (Key Takeaways)
- MLOps là chìa khóa chống lại sự suy thoái tất yếu của mô hình (Model Degradation) trên môi trường Production.
- Data Drift ( đổi) phát hiện được ngay bằng PSI / KS-Test; Concept Drift ( đổi) chỉ phát hiện được khi có nhãn thực tế .
- Ngưỡng chuẩn là ranh giới kích hoạt quy trình Tái huấn luyện mô hình (Continuous Training).
- Triển khai mô hình an toàn tuyệt đối bằng chuỗi quy trình: Shadow Testing Canary Release Automated Rollback.