[DE Blog #46] Xử Lý Luồng Phân Tán Chuyên Sâu: So Sánh Toàn Diện Apache Flink vs. Spark Structured Streaming, State Management, Savepoints & Cơ Chế Backpressure Control
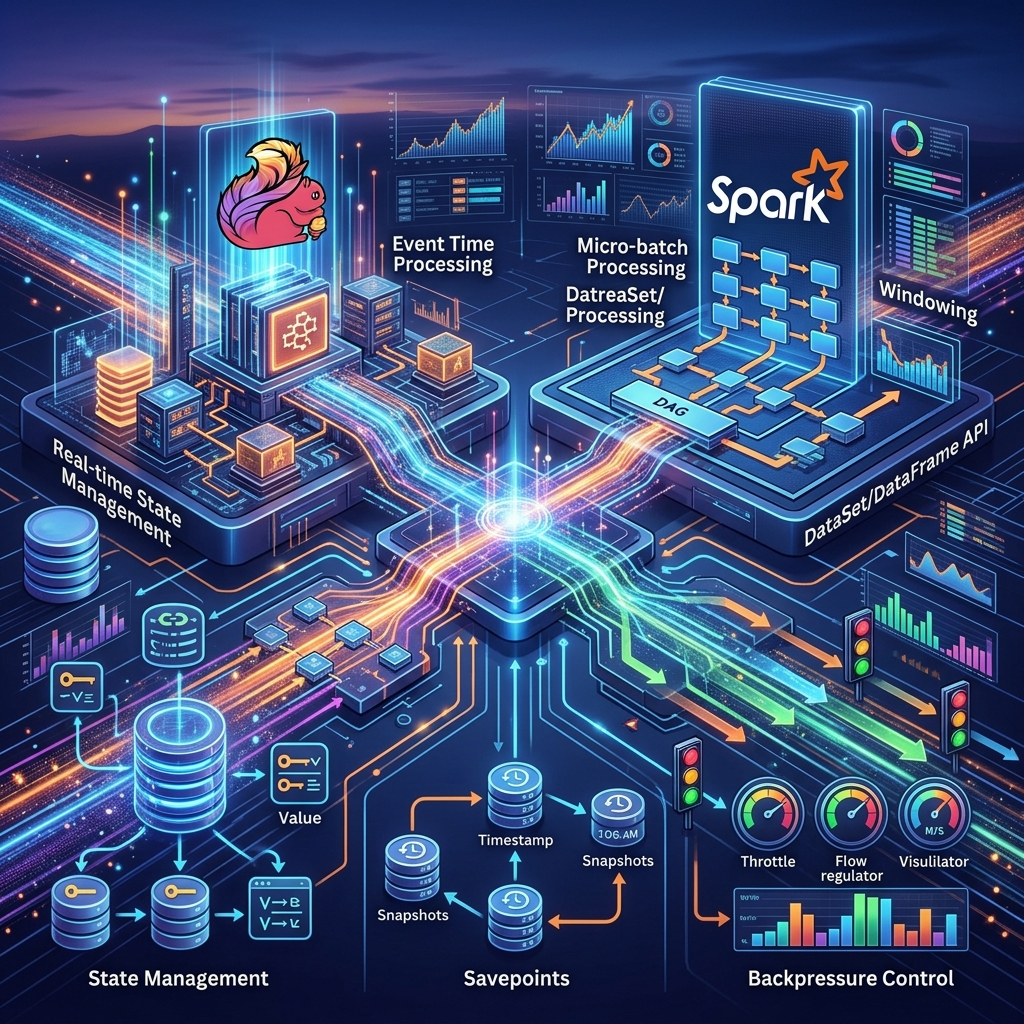
1. Bối cảnh thực tế (Context & Problem Statement)
Trong kỷ nguyên dữ liệu thời gian thực, câu hỏi kiến trúc kinh điển nhất mà mọi Data Architect và Lead Data Engineer phải trả lời khi bắt đầu một dự án Streaming là:
“Chúng ta nên chọn Apache Flink hay Apache Spark Structured Streaming?”
Cả hai công cụ đều là những kỳ quan của công nghệ điện toán phân tán, nhưng chúng được sinh ra từ hai trường phái triết lý hoàn toàn trái ngược:
- Triết lý của Apache Spark: "Mọi luồng dữ liệu thời gian thực thực chất chỉ là một chuỗi các tập dữ liệu tĩnh vô hạn được chia nhỏ thành từng đợt siêu vi (A continuous stream is just a series of small batch computations - Micro-batching)".
- Triết lý của Apache Flink: "Dữ liệu theo lô (Batch) thực chất chỉ là một trường hợp đặc biệt của dữ liệu luồng (Streaming), trong đó dòng chảy dữ liệu có một điểm bắt đầu và một điểm kết thúc xác định (Batch is a special case of streaming)".
Sự khác biệt về triết lý này kéo theo hàng loạt sự đánh đổi cốt tử về: Độ trễ xử lý (Latency: Sub-millisecond vs. Sub-second), Cơ chế kiểm soát áp lực ngược (Backpressure), và Năng lực quản lý trạng thái (Stateful Stream Processing) khi hệ thống xử lý hàng trăm nghìn sự kiện mỗi giây.
2. Các Khái Niệm & Cơ Chế Cốt Lõi
2.1. Cơ Chế Xử Lý: Native Event-Driven (Flink) vs. Micro-Batching (Spark)
SPARK STRUCTURED STREAMING (Micro-Batching):
[Stream] ---> [Bộ đệm gom 500ms] ---> [Batch Job 1] ---> [Driver Lập lịch] ---> [Executors tính toán]
         ---> [Bộ đệm gom 500ms] ---> [Batch Job 2] ---> [Driver Lập lịch] ---> [Executors tính toán]
         (Độ trễ tối thiểu: 100ms - 500ms do chi phí lập lịch của Driver)

APACHE FLINK (Native Event-Driven Pipelined Streaming):
[Event 1] ---> [Operator 1] ===(Streaming Memory Pipe)===> [Operator 2] ---> [Sink]
[Event 2] ---> [Operator 1] ===(Streaming Memory Pipe)===> [Operator 2] ---> [Sink]
         (Xử lý từng sự kiện ngay lập tức khi vừa đến -> Độ trễ Sub-millisecond: < 5ms)
- Spark Structured Streaming (Mặc định): Gom các sự kiện đến trong một khoảng thời gian ngắn (Trigger interval, ví dụ ) thành một mini RDD/DataFrame. Engine tận dụng toàn bộ bộ tối ưu hóa Catalyst Optimizer và Tungsten Engine của Spark Batch.
- Apache Flink: Kiến trúc hướng sự kiện thuần túy. Mỗi TaskManager duy trì các luồng tính toán chạy liên tục. Một sự kiện vừa xuất hiện ở Source sẽ được đẩy ngay qua đường ống bộ nhớ (Pipelined Data Exchange) đến các Operator tiếp theo mà không cần bộ đệm thời gian.
2.2. Quản Lý Trạng Thái Phân Tán (State Management Internals)
Trong các bài toán như: Đếm số giao dịch của 1 thẻ ngân hàng trong 10 phút, hoặc làm giàu dữ liệu (Stream-Stream Join), hệ thống bắt buộc phải duy trì trạng thái (State).
- Trong Apache Flink (Stateful Native):
- Hỗ trợ 2 loại State: Operator State (Gắn liền với từng task instance, ví dụ: Kafka Source Offset) và Keyed State (Phân mảnh theo
keyBy(), ví dụ:ValueState,ListState,MapState). - EmbeddedRocksDBStateBackend: Lưu trữ State trên ổ đĩa SSD cục bộ (Local NVMe) thông qua cơ sở dữ liệu nhúng C++ RocksDB. Cho phép dung lượng State mở rộng lên tới hàng chục Terabytes, chỉ bị giới hạn bởi dung lượng đĩa cứng mà không bị ảnh hưởng bởi JVM Garbage Collection (GC).
- Hỗ trợ 2 loại State: Operator State (Gắn liền với từng task instance, ví dụ: Kafka Source Offset) và Keyed State (Phân mảnh theo
- Trong Spark Structured Streaming:
- Quản lý trạng thái qua các hàm
mapGroupsWithState()hoặcflatMapGroupsWithState(). - Trước Spark 3.2, mặc định sử dụng
HDFSBackedStateStoreProvider(Lưu state trên Java Heap Rất dễ sập OOM khi state lớn). - Từ Spark 3.2+, bổ sung thêm RocksDBStateStoreProvider để giảm tải áp lực RAM, nhưng cơ chế lưu vết delta state vẫn gắn liền với chu kỳ micro-batch.
- Quản lý trạng thái qua các hàm
2.3. Tính Toàn Vẹn & Khả Năng Chịu Lỗi: Checkpoints vs. Savepoints (Đặc Quyền Của Flink)
- Flink Checkpoint (Tự động & Định kỳ):
- Cơ chế tự động hóa hoàn toàn dựa trên thuật toán Asynchronous Barrier Snapshotting (Biến thể của Chandy-Lamport).
- Mục đích duy nhất: Khôi phục lỗi tự động (Automatic Failure Recovery) khi có worker node bị chết. Dữ liệu được ghi ở định dạng nhị phân tối ưu hóa cao cho máy tính đọc, gắn chặt với cấu hình cluster hiện tại.
- Flink Savepoint (Kích hoạt thủ công bởi Kỹ sư):
- Được kích hoạt thông qua lệnh CLI (
flink savepoint <job_id> <s3_path>). - Là một bản chụp trạng thái nhất quán toàn diện (Consistent Image) của toàn bộ ứng dụng, được lưu ở định dạng chuẩn hóa độc lập (Canonical / Portable Format).
- Công dụng thần kỳ trong vận hành Production:
- Nâng cấp mã nguồn không gián đoạn (Zero-Downtime Code Upgrade): Sửa code Java/Scala Dừng job cũ tạo Savepoint Bật job mới nạp lại State từ Savepoint.
- Mở rộng/Thu hẹp tài nguyên (Rescaling): Đổi độ song song (Parallelism) từ 10 lên 50 workers mà không làm mất lịch sử tính toán.
- A/B Testing & State Rollback: Khôi phục lại trạng thái dữ liệu của 2 tiếng trước khi phát hiện thuật toán mới bị lỗi logic.
- Được kích hoạt thông qua lệnh CLI (
2.4. Cơ Chế Kiểm Soát Áp Lực Ngược: Credit-Based Flow Control Của Flink
Khi tầng Sink (ví dụ: Database đích bị nghẽn đĩa) không kịp tiêu thụ dữ liệu, nếu các tầng Source cứ tiếp tục nạp dữ liệu với tốc độ cao, hệ thống sẽ bị nổ tung bộ nhớ RAM.
- Credit-Based Flow Control (Flink 1.5+ ở tầng mạng Netty):
- Mỗi kết nối mạng giữa hai TaskManager được gán các bộ đệm cố định: Exclusive Buffers và Floating Buffers (Dùng chung).
- Cơ chế hoạt động:
- Node nhận (Downstream) gửi một tín hiệu Credit (số lượng bộ đệm còn trống) cho Node gửi (Upstream).
- Node gửi chỉ được phép phát đi số lượng gói tin dữ liệu đúng bằng số Credit mà Downstream đang có.
- Nếu Downstream bị nghẽn xử lý không kịp giải phóng bộ đệm Credit giảm về Upstream ngừng gửi dữ liệu qua mạng ngay lập tức!
- Hiện tượng nghẽn này lan truyền ngược tự nhiên từ Sink Transformation Source. Khi Source bị nghẽn, nó sẽ tự động giảm tốc độ đọc từ Kafka (ngừng poll) mà hoàn toàn không làm tràn bộ nhớ hay tiêu tốn tài nguyên CPU vô ích.
[Downstream TaskManager] ---> Báo tín hiệu: "Tôi còn 2 Credit (2 ô đệm trống)" ---> [Upstream TaskManager]
[Downstream TaskManager] <=== Chỉ gửi đúng 2 Data Buffers (Hết hạn mức!) <=== [Upstream TaskManager]
(Nếu Downstream bận, Credit = 0 -> Upstream tự động ngừng gửi ngay lập tức!)
3. Các Bảng Markdown So Sánh Chi Tiết
📊 Bảng 1: So Sánh Toàn Diện: Apache Flink vs. Spark Structured Streaming
| Tiêu chí kỹ thuật | Apache Flink | Spark Structured Streaming (Micro-Batch) |
|---|---|---|
| Mô hình kiến trúc | Native Event-Driven Streaming | Micro-Batching (Gom cụm thời gian nhỏ) |
| Độ trễ xử lý (Latency) | Siêu thấp (Sub-millisecond: ) | Thấp () |
| Thông lượng tối đa (Throughput) | Rất cao | Cực cao (Nhờ tối ưu hóa Vectorized execution trên batch) |
| Quản lý State dung lượng lớn | Mạnh nhất thế giới (Tích hợp sâu RocksDB NVMe SSD) | Khá (Có hỗ trợ RocksDB từ bản 3.2+) |
| Độ linh hoạt của Windowing | Vô đối (Tumbling, Sliding, Session, Custom triggers) | Tốt (Tumbling, Sliding theo Event Time) |
| Nâng cấp Code & State Evolution | Hoàn hảo nhờ tính năng Savepoints độc quyền | Hạn chế (Dễ làm vỡ schema checkpoint nếu đổi code) |
| Hệ sinh thái đi kèm | Chuyên sâu về Real-time, Flink CDC, CEP | Hệ sinh thái toàn năng (Spark SQL, Batch, MLlib, GraphX) |
| Mức độ phức tạp vận hành | Cao (Cần chuyên môn sâu về phân bổ Memory/Slots) | Thấp/Trung bình (Dùng chung cụm cluster với Spark Batch) |
📊 Bảng 2: So Sánh Chi Tiết: Flink Checkpoint vs. Flink Savepoint
| Tiêu chí | Flink Checkpoint | Flink Savepoint |
|---|---|---|
| Phương thức kích hoạt | Tự động theo chu kỳ định cấu hình | Kích hoạt thủ công bởi Kỹ sư / CI-CD pipeline |
| Định dạng lưu trữ | Nhị phân đặc thù, tối ưu hóa riêng cho từng State Backend | Định dạng chuẩn hóa di động (Canonical / Portable) |
| Khả năng chuyển đổi Cluster | Gắn chặt với phiên bản và cấu trúc cụm hiện tại | Di động hoàn toàn (Đổi cụm, đổi máy chủ, đổi phiên bản Flink) |
| Khả năng thay đổi Parallelism | Khó khăn | Rất dễ dàng (Tự động phân bổ lại state cho workers mới) |
| Vòng đời tồn tại | Tự động bị xóa khi Job kết thúc hoặc hủy | Tồn tại vĩnh viễn trên S3 cho đến khi người dùng chủ động xóa |
| Mục đích sử dụng chính | Khôi phục sự cố tự động khi sập Node (Fault-Tolerance) | Bảo trì, Nâng cấp code, Đổi cấu hình, Rollback dữ liệu |
📊 Bảng 3: So Sánh Cơ Chế Xử Lý Backpressure: Flink vs. Spark Streaming
| Tiêu chí | Flink Credit-Based Flow Control | Spark Streaming PID Rate Controller |
|---|---|---|
| Tầng can thiệp | Tầng mạng truyền tải dữ liệu (Netty Transport Layer) | Tầng lập lịch xử lý của Driver (Batch Scheduler) |
| Thời gian phản ứng | Tức thì (Real-time theo từng mili-giây) | Có độ trễ (Chờ batch hiện tại hoàn thành mới tính lại) |
| Cơ chế điều tiết | Giới hạn số lượng packet buffers gửi qua socket | Dùng giải thuật PID để tính toán số dòng tối đa cho batch sau |
| Nguy cơ tràn bộ nhớ (OOM) | Bằng 0 (Không thể gửi nếu phía nhận không có buffer rỗng) | Thấp (nếu PID Controller được bật) |
4. Best Practices & Vận Hành Flink / Spark Streaming Thực Chiến (Pro-Tips)
💡 Khắc Phục Nghẽn RocksDB State Backend Trong Apache Flink
- Cạm bẫy: Mặc định RocksDB chạy mã C++ Native ngoài vùng quản lý của JVM (Off-Heap). Nếu không giới hạn bộ nhớ, tiến trình RocksDB có thể chiếm toàn bộ RAM của máy chủ, khiến hệ điều hành kích hoạt Linux OOM Killer và giết chết TaskManager!
- Quy tắc cấu hình vàng:
# Bật cơ chế Flink tự động quản lý bộ nhớ RocksDB:
state.backend.rocksdb.memory.managed: true
state.backend.rocksdb.memory.write-buffer-ratio: 0.5
state.backend.rocksdb.memory.high-priority-pool-ratio: 0.1
# Luôn bật tính năng Checkpoint gia tăng (Incremental Checkpointing):
state.backend.incremental: true
💡 Quy Trình Nâng Cấp Code Ứng Dụng Flink Bằng Savepoint
Khi cần sửa đổi logic code của một Streaming Pipeline đang chạy xử lý hàng chục triệu sự kiện:
# 1. Dừng job an toàn và xuất bản chụp trạng thái Savepoint lên S3:
flink stop --savepointPath s3://my-flink-bucket/savepoints/ <JOB_ID>

# 2. Deploy file JAR mới và khôi phục trạng thái chính xác:
flink run -d \
  -s s3://my-flink-bucket/savepoints/savepoint-<JOB_ID>-<TOKEN> \
  -c com.company.streaming.NewRealTimeJob \
  my-new-streaming-app.jar
5. Góc Ôn Luyện Phỏng Vấn (Interview Corner)
❓ Câu hỏi 1: Giải thích cơ chế hoạt động của thuật toán Credit-Based Flow Control trong Apache Flink. Nó giúp Flink phát hiện và xử lý hiện tượng Backpressure như thế nào ở tầng mạng Netty mà không làm sập bộ nhớ của các Worker nodes?
- Gợi ý trả lời:
- Vấn đề của cơ chế cũ (TCP Flow Control): Trước đây Flink dựa vào cửa sổ TCP Window. Khi downstream bị nghẽn, socket buffer bị đầy, làm tắc nghẽn toàn bộ kết nối multiplexing dùng chung giữa 2 TaskManager, làm ảnh hưởng lây lan sang cả các luồng dữ liệu không bị nghẽn khác.
- Cơ chế Credit-Based Flow Control:
- Tại mỗi kênh kết nối (InputChannel) của TaskManager nhận, Flink phân bổ một số lượng Exclusive Buffers cố định và một nhóm Floating Buffers dùng chung.
- Mỗi khi InputChannel có các buffer trống, nó sẽ gửi một giá trị số nguyên gọi là Credit (số ô đệm sẵn sàng nhận) đính kèm vào các gói tin báo nhận gửi ngược về cho TaskManager gửi (Upstream).
- Phía gửi chỉ được phép phát đi số lượng gói tin dữ liệu đúng bằng số Credit nhận được. Sau khi gửi hết số Credit cho phép, phía gửi chủ động dừng phát dữ liệu ngay lập tức.
- Xử lý Backpressure không gây sập RAM:
- Nếu một Operator xử lý chậm, các buffer của nó không được giải phóng Credit trả về bằng Operator phía trước không thể đẩy dữ liệu đi Bộ đệm của chính nó cũng bị đầy Nó lại trả Credit bằng về cho tầng phía trước nữa.
- Hiện tượng điều tiết này lan truyền ngược tự nhiên từ Sink về tới Source trong vòng vài mili-giây. Khi Source nhận thấy không còn Credit, nó ngừng poll dữ liệu từ Kafka.
- Dữ liệu dư thừa nằm an toàn trên đĩa cứng của Kafka cluster, toàn bộ bộ nhớ RAM của cụm Flink được bảo vệ an toàn tuyệt đối mà không có bất kỳ rủi ro OOM nào.
❓ Câu hỏi 2: So sánh sự khác nhau bản chất giữa Checkpoint và Savepoint trong Apache Flink. Trong những tình huống vận hành thực tế nào một Data Engineer bắt buộc phải sử dụng Savepoint thay vì dựa vào Checkpoint tự động?
- Gợi ý trả lời:
- Sự khác biệt bản chất:
- Checkpoint là cơ chế chịu lỗi tự động (System-owned): Được thiết kế cho máy móc, lưu trữ ở định dạng nhị phân thô tối ưu riêng cho từng State Backend để tốc độ snapshot và phục hồi đạt nhanh nhất. Không đảm bảo tính tương thích nếu thay đổi cấu trúc cluster hoặc nâng cấp code.
- Savepoint là cơ chế quản trị người dùng (User-owned): Được kích hoạt thủ công, lưu trữ ở định dạng chuẩn hóa độc lập (Canonical representation).
- 4 Tình huống thực tế BẮT BUỘC dùng Savepoint:
- Nâng cấp logic mã nguồn ứng dụng (Application Code Changes): Khi bạn sửa code biến đổi hoặc thêm bớt các trường dữ liệu, Checkpoint cũ sẽ không thể deserialize được. Savepoint cho phép ánh xạ State cũ vào code mới an toàn nhờ cơ chế gán định danh cố định
uid("operator-name"). - Thay đổi độ song song (Rescaling Parallelism): Khi lưu lượng tăng cao, bạn muốn nâng số worker từ lên TaskManagers. Nạp từ Savepoint sẽ tự động chia nhỏ lại các Key-Groups để phân bổ đều cho 50 workers mới.
- Nâng cấp phiên bản phần mềm Flink (Flink Version Upgrade): Ví dụ nâng cấp từ Flink 1.17 lên Flink 1.20, Savepoint đảm bảo tính tương thích xuôi ngược (Backward/Forward Compatibility).
- Forking / A/B Testing trên môi trường Staging: Dùng một bản Savepoint từ Production để khởi chạy một job thử nghiệm song song trên môi trường Dev/Staging với đúng trạng thái dữ liệu thực tế.
- Nâng cấp logic mã nguồn ứng dụng (Application Code Changes): Khi bạn sửa code biến đổi hoặc thêm bớt các trường dữ liệu, Checkpoint cũ sẽ không thể deserialize được. Savepoint cho phép ánh xạ State cũ vào code mới an toàn nhờ cơ chế gán định danh cố định
- Sự khác biệt bản chất:
❓ Câu hỏi 3: Khi nào bạn nên lựa chọn Apache Flink và khi nào nên chọn Spark Structured Streaming cho dự án Real-Time Data Engineering của doanh nghiệp? Hãy phân tích các yếu tố đánh đổi về độ trễ, chi phí hạ tầng và đội ngũ phát triển.
- Gợi ý trả lời (Ma trận đánh đổi chiến lược):
- NÊN CHỌN APACHE FLINK KHI:
- Yêu cầu độ trễ siêu thấp (Sub-second SLA ): Các bài toán nhạy cảm về thời gian thực như Phát hiện gian lận thanh toán (Fraud Detection), Đấu giá quảng cáo (RTB), Cảnh báo an toàn hệ thống IoT.
- Cần xử lý trạng thái phức tạp (Complex Stateful Streaming): Các bài toán cần duy trì State khổng lồ hàng Terabytes, các phép Join giữa 2 dòng stream có độ trễ lớn, hoặc xử lý các mẫu sự kiện phức tạp (Complex Event Processing - Flink CEP).
- Yêu cầu khả năng nâng cấp hệ thống không gián đoạn (Zero-Downtime Migration qua Savepoints).
- NÊN CHỌN SPARK STRUCTURED STREAMING KHI:
- Độ trễ chấp nhận được ở mức vài giây đến vài phút (Near Real-time SLA ): Các bài toán như Nạp dữ liệu liên tục vào Data Lakehouse (Bronze/Silver ingestion), Báo cáo Dashboard cập nhật mỗi phút.
- Tận dụng chung hạ tầng và nhân sự (Unified Batch & Stream): Nếu doanh nghiệp đã có sẵn một cụm Spark lớn phục vụ ETL/ML và đội ngũ kỹ sư đã thành thạo Spark/PySpark, việc dùng tiếp Structured Streaming giúp tiết kiệm chi phí vận hành và không cần tuyển thêm kỹ sư chuyên sâu về Flink.
- Tái sử dụng chung code logic: Cùng một câu lệnh SQL hoặc logic xử lý DataFrame có thể chạy chung cho cả luồng Batch nạp lịch sử lẫn luồng Streaming thời gian thực (Write once, run both).
- NÊN CHỌN APACHE FLINK KHI:
6. Tóm Tắt Ghi Nhớ Nhanh (Key Takeaways)
- Apache Flink là kiến trúc Native Event-Driven (Độ trễ Sub-millisecond); Spark Structured Streaming là kiến trúc Micro-Batching (Độ trễ Sub-second, Thông lượng Batch tối ưu).
- RocksDB State Backend là vũ khí tối thượng của Flink giúp mở rộng dung lượng State lên đến hàng chục Terabytes trên ổ đĩa NVMe SSD cục bộ.
- Savepoint là đặc quyền của Flink giúp Nâng cấp code, Đổi độ song song (Rescaling) và Bảo trì hệ thống với thời gian Downtime bằng 0.
- Credit-Based Flow Control là cơ chế điều tiết áp lực ngược (Backpressure) ở tầng mạng Netty, bảo vệ cụm máy chủ Flink không bao giờ bị sập bộ nhớ RAM.
- Chọn Flink cho bài toán Real-Time khắt khe & Stateful CEP; chọn Spark Streaming khi cần Hợp nhất hạ tầng Batch/ETL và tối ưu chi phí vận hành.