[DE Blog #50] Giao Thức Đồng Thuận Phân Tán (Distributed Consensus) & Giao Dịch Phân Tán: Giải Mã Thuật Toán Raft vs. Paxos, Two-Phase Commit (2PC) & Mẫu Thiết Kế Saga Pattern
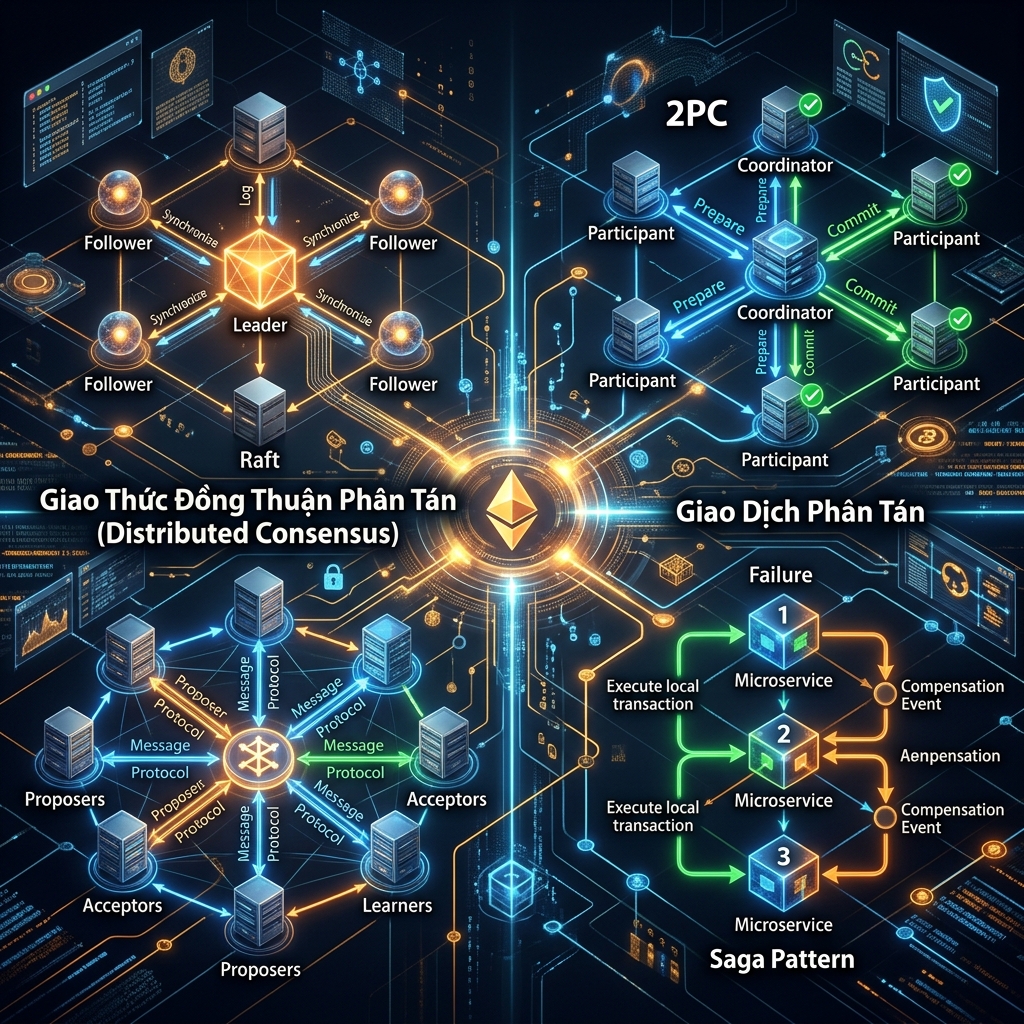
1. Bối cảnh thực tế (Context & Problem Statement)
Trong một máy chủ đơn lẻ (Single Node), việc thực hiện một giao dịch ACID (ví dụ: Chuyển tiền từ tài khoản sang ) vô cùng đơn giản: Database Engine chỉ cần sử dụng cơ chế khóa cục bộ (Local Locks) và ghi nhật ký Write-Ahead Log (WAL).
Tuy nhiên, trong Hệ thống dữ liệu phân tán (Distributed Data Systems):
- Dữ liệu được phân mảnh và nhân bản trên hàng chục cụm máy chủ đặt tại nhiều trung tâm dữ liệu khác nhau.
- Các ảo tưởng của điện toán phân tán (Fallacies of Distributed Computing): Mạng không bao giờ hoàn hảo; các gói tin có thể bị trễ, bị đảo lộn thứ tự, bị mất mát; các máy chủ có thể bị crash hoặc mất kết nối đột ngột (Network Partition).
Hai bài toán sống còn mà mọi kỹ sư dữ liệu lớn phải đối mặt:
- Làm thế nào để hàng chục node độc lập luôn đạt được sự thống nhất về thứ tự các sự kiện (Distributed Consensus) mà không xảy ra hiện tượng "Não phân liệt" (Split-Brain)? Giải quyết bằng Raft / Paxos (Trái tim của Kafka KRaft, etcd, TiDB, CockroachDB).
- Làm thế nào để thực hiện một giao dịch thương mại xuyên suốt qua 5 Microservices độc lập (Tạo đơn Trừ kho Thanh toán Tích điểm Giao hàng) với tính toàn vẹn tuyệt đối mà không làm khóa chết hệ thống? Giải quyết bằng Two-Phase Commit (2PC) hoặc Saga Pattern.
2. Các Khái Niệm & Cơ Chế Cốt Lõi
2.1. Định Lý Bất Khả FLP (Fischer, Lynch, Paterson - 1985)
Định lý nền tảng của khoa học máy tính chứng minh rằng: Trong một hệ thống mạng phân tán bất đồng bộ (Asynchronous Network), không thể tồn tại một thuật toán đồng thuận tất định (Deterministic Consensus) nào vừa đảm bảo tính Đúng đắn (Safety) vừa đảm bảo tính Kết thúc (Liveness) nếu chỉ có duy nhất 1 node gặp sự cố crash mà không báo trước.
- Hệ quả thực tế: Mọi thuật toán đồng thuận hiện đại (Paxos, Raft) đều phải chấp nhận hy sinh: Chúng đảm bảo Safety tuyệt đối (không bao giờ quyết định sai), nhưng chấp nhận có những thời điểm hệ thống tạm thời không phục vụ ghi (Mất Liveness tạm thời) khi đang xảy ra bầu cử Leader trong điều kiện đứt mạng phân vùng.
2.2. Thuật Toán Đồng Thuận Raft (Ongaro & Ousterhout - Stanford 2014)
Thuật toán Paxos của Leslie Lamport (1998) nổi tiếng là cực kỳ trừu tượng và khó cài đặt chính xác trong thực tế. Raft ra đời với mục tiêu tối thượng: Khả năng hiểu được (Understandability), chia bài toán đồng thuận thành 3 bài toán con độc lập:
1. Bầu cử Trưởng nhóm (Leader Election):
- Một node trong Raft luôn ở 1 trong 3 trạng thái: Follower, Candidate, hoặc Leader.
- Thời gian được chia thành các nhiệm kỳ (Terms) tăng dần:
- Các Follower duy trì một bộ đếm ngẫu nhiên Election Timeout (). Nếu không nhận được tín hiệu Heartbeat từ Leader:
- Follower tự tăng Term lên , chuyển thành Candidate, tự bỏ phiếu cho mình và phát lệnh
RequestVote RPCtới tất cả các node khác. - Node nào nhận được Đa số phiếu bầu (Strict Majority / Quorum: ) sẽ trở thành Leader mới.
- Quy tắc ngăn chặn Split-Brain: Vì để thắng cử bắt buộc phải có tổng số phiếu, trong một Term tuyệt đối không thể có 2 Leader cùng đắc cử!
- Follower tự tăng Term lên , chuyển thành Candidate, tự bỏ phiếu cho mình và phát lệnh
2. Sao chép nhật ký (Log Replication):
- Mọi yêu cầu ghi từ Client bắt buộc phải gửi tới Leader.
- Leader ghi lệnh vào log nội bộ của mình, sau đó gửi gói tin
AppendEntries RPCtới tất cả các Followers. - Khi lệnh đó đã được nhân bản thành công trên Đa số các node (Quorum), Leader chính thức Commit lệnh đó, áp dụng vào State Machine và trả kết quả thành công về cho Client.
- Leader sẽ thông báo cho các Followers biết lệnh đã commit ở các gói tin heartbeat tiếp theo.
3. Tính An toàn (Election Safety Restriction):
- Một Follower sẽ từ chối bỏ phiếu cho một Candidate nếu Log của Candidate đó cũ hơn hoặc ngắn hơn Log của chính nó Đảm bảo một Leader mới đắc cử luôn chứa toàn bộ các bản ghi log đã từng được Commit trong quá khứ.
[Client] ---> Lệnh: "SET x = 5"
                 |
                 v
       +------------------+
       |   RAFT LEADER    | (Ghi vào Log nội bộ: Index 1)
       +--------+---------+
                |
        +-------+-------+ (AppendEntries RPC)
        |               |
        v               v
  +-----------+   +-----------+
  | Follower  |   | Follower  |  ---> Cả 2 đã nhận và ghi đĩa thành công!
  +-----------+   +-----------+
        |               |
        +-------+-------+
                | (Báo nhận thành công: Đạt đa số Quorum 3/3 nodes!)
                v
       +------------------+
       |  LEADER COMMITS  | ===> Áp dụng vào State Machine -> Trả về kết quả cho Client!
       +------------------+
2.3. Giao Thức Two-Phase Commit (2PC - Cam Kết Hai Giai Đoạn)
2PC là giao thức cổ điển dùng để đảm bảo tính nguyên tử (Atomicity) của một giao dịch trải dài trên nhiều cơ sở dữ liệu độc lập:
- Giai đoạn 1: Chuẩn bị (Prepare Phase):
- Điều phối viên (Coordinator) gửi thông điệp
Preparetới tất cả các node tham gia (Participants). - Mỗi Participant kiểm tra: Ghi nhật ký Undo/Redo Log, khóa tài nguyên cần sửa và trả lời:
VOTE_COMMIT(Đồng ý) hoặcVOTE_ABORT(Từ chối).
- Điều phối viên (Coordinator) gửi thông điệp
- Giai đoạn 2: Cam kết (Commit Phase):
- Nếu TẤT CẢ các bên đều gửi
VOTE_COMMIT: Coordinator ghi log và phát lệnhGLOBAL_COMMIT. Các bên ghi dữ liệu chính thức, giải phóng khóa và trả về thành công. - Nếu CÓ ÍT NHẤT 1 bên gửi
VOTE_ABORT(hoặc timeout): Coordinator phát lệnhGLOBAL_ABORT. Tất cả các bên dùng Undo Log để khôi phục trạng thái ban đầu và giải phóng khóa.
- Nếu TẤT CẢ các bên đều gửi
⚠️ Tử huyệt của 2PC (Blocking Problem & Coordinator SPOF):
2PC là một giao thức Khóa chặn đồng bộ (Synchronous & Blocking). Nếu sau khi các bên đã bỏ phiếuVOTE_COMMITmà Coordinator bị sập nguồn đột ngột:
Toàn bộ các Participant phải ôm khóa tài nguyên (Holding Locks) và chờ đợi vô thời hạn! Không bên nào dám tự ý Commit cũng không dám tự ý Rollback, làm tê liệt toàn bộ hệ thống.
2.4. Mẫu Thiết Kế Saga Pattern (Giao Dịch Phân Tán Bất Đồng Bộ)
Trong kiến trúc Microservices và Big Data, việc giữ khóa bằng 2PC sẽ phá hủy hoàn toàn thông lượng (Throughput). Saga Pattern thay thế giao dịch ACID phân tán bằng một chuỗi các Giao dịch cục bộ (Local Transactions) độc lập:
- Mỗi Service chỉ thực hiện giao dịch trên chính Database nội bộ của nó và phát ra một Sự kiện (Event/Message).
- Cơ chế Bù trừ (Compensating Transactions): Nếu một bước ở giữa bị thất bại (ví dụ tài khoản không đủ tiền thanh toán), Saga sẽ kích hoạt chuỗi các Giao dịch bù trừ theo chiều ngược lại để hoàn tác lại các bước đã làm trước đó (ví dụ: Mở lại số lượng tồn kho đã trừ tạm).
LUỒNG THÀNH CÔNG (Happy Path):
[1. Tạo Đơn] ---> [2. Trừ Kho] ---> [3. Thanh Toán] ---> [4. Giao Hàng] (Xong)

LUỒNG THẤT BẠI & BÙ TRỪ (Compensating Flow khi Bước 3 lỗi):
[1. Tạo Đơn] ---> [2. Trừ Kho] ---> [3. Thanh Toán THẤT BẠI!]
      |                |
      v                v
[Hủy Đơn Hàng] <-- [Bù trừ: Cộng lại Kho]  (Khôi phục trạng thái nhất quán cuối cùng)
2 Mô Hình Triển Khai Saga:
- Choreography (Biên đạo múa / Tự trị phi tập trung): Các Service giao tiếp trực tiếp với nhau qua Message Broker (Apache Kafka). Service làm xong phát sự kiện, Service nghe thấy sự kiện thì tự động làm tiếp.
(Ưu điểm: Không có điểm nghẽn tập trung; Nhược điểm: Khó kiểm soát luồng khi có services, dễ bị vòng lặp sự kiện). - Orchestration (Chỉ huy dàn nhạc / Điều phối tập trung): Một Service chuyên trách (Saga Orchestrator, ví dụ dùng Temporal, Camunda, AWS Step Functions) đóng vai trò máy trạng thái (State Machine) gửi lệnh điều phối tuần tự tới từng Service.
(Ưu điểm: Dễ quản lý, dễ theo dõi tiến độ, dễ xử lý timeout; Nhược điểm: Cần duy trì thêm hạ tầng Orchestrator).
3. Các Bảng Markdown So Sánh Chi Tiết
📊 Bảng 1: So Sánh Các Thuật Toán Đồng Thuận Phân Tán: Raft vs. Multi-Paxos vs. ZAB
| Tiêu chí kỹ thuật | Raft | Multi-Paxos | ZAB (ZooKeeper Atomic Broadcast) |
|---|---|---|---|
| Mục tiêu thiết kế | Dễ hiểu, dễ cài đặt và bảo trì | Hiệu năng tối đa về mặt lý thuyết | Chuyên sâu cho hệ thống cây dữ liệu ZooKeeper |
| Vai trò của Leader | Strong Leader (Mọi ghi nạp và đồng bộ log đều qua Leader) | Yếu hơn (Có thể ghi qua nhiều Proposers) | Strong Leader (Hỗ trợ 2 pha: Phục hồi và Phát sóng) |
| Xử lý xung đột Log | Leader ghi đè log của Followers nếu lệch pha | Bầu chọn và đàm phán từng vị trí log độc lập | Dùng mã số giao dịch tuần tự zxid (Epoch + Counter) |
| Độ phức tạp khi cài đặt | Thấp nhất trong các thuật toán đồng thuận | Cực kỳ phức tạp (Nhiều biến thể không chuẩn hóa) | Phức tạp |
| Dự án thực tế tiêu biểu | Kafka KRaft, etcd (Kubernetes), TiKV, HashiCorp Consul | Google Spanner, Chubby Lock Service | Apache ZooKeeper (Kafka cũ, Hadoop NameNode) |
📊 Bảng 2: So Sánh Two-Phase Commit (2PC) vs. Three-Phase Commit (3PC) vs. Saga Pattern
| Tiêu chí | Two-Phase Commit (2PC) | Three-Phase Commit (3PC) | Saga Pattern |
|---|---|---|---|
| Mô hình tính nhất quán | Strong Consistency (ACID tuyệt đối) | Strong Consistency | Eventual Consistency (BASE - Nhất quán cuối cùng) |
| Cơ chế Khóa tài nguyên | Giữ khóa đồng bộ xuyên suốt giao dịch (Blocking) | Giữ khóa đồng bộ | Hoàn toàn KHÔNG giữ khóa giữa các services |
| Thông lượng (Throughput) | Rất thấp (Nghẽn cổ chai khi số node tăng) | Rất thấp | Cực cao (Xử lý bất đồng bộ qua Kafka) |
| Xử lý khi Coordinator chết | Bị treo hệ thống (Blocking indefinitely) | Tự động phục hồi qua trạng thái Pre-Commit | Orchestrator tự động kích hoạt timeout và bù trừ |
| Khả năng mở rộng (Scale) | Kém (Không phù hợp cho Microservices) | Kém | Xuất sắc (Chuẩn mực cho Microservices hiện đại) |
📊 Bảng 3: So Sánh Saga Choreography vs. Saga Orchestration
| Tiêu chí | Saga Choreography (Phi tập trung) | Saga Orchestration (Điều phối tập trung) |
|---|---|---|
| Cơ chế giao tiếp | Event-Driven qua Message Broker (Kafka/RabbitMQ) | Lệnh gọi trực tiếp (Command/Response qua gRPC / REST / State Machine) |
| Điểm điều phối trung tâm | Không có (Decentralized) | Có (Saga Orchestrator Coordinator) |
| Khả năng quan sát (Observability) | Khó khăn (Dòng chảy phân tán, khó vẽ đồ thị trạng thái) | Rất dễ dàng (Toàn bộ trạng thái giao dịch nằm tại 1 nơi) |
| Độ phụ thuộc giữa các Services | Khớp nối lỏng (Loose Coupling) | Phụ thuộc vào giao diện điều phối của Orchestrator |
| Rủi ro vòng lặp chu trình (Cycles) | Dễ xảy ra nếu các service vô tình phát sự kiện chéo | Hoàn toàn bị loại bỏ |
| Quy mô phù hợp | Quy trình đơn giản ( bước) | Quy trình phức tạp ( bước: E-commerce Checkout, Booking) |
4. Best Practices & Kỹ Thuật Triển Khai Thực Chiến (Pro-Tips)
💡 Quy Tắc Số Lượng Node Trong Cụm Raft / Paxos (Quorum Math)
- Luôn triển khai số lượng máy chủ là Số lẻ ():
- Công thức tính số lượng node lỗi tối đa cho phép:
- So sánh:
- Cụm 3 nodes: Cho phép chết tối đa node (Quorum ).
- Cụm 4 nodes: Cũng chỉ cho phép chết tối đa node (Quorum ).
Thêm node thứ 4 tốn thêm tiền phần cứng nhưng KHÔNG hề tăng thêm khả năng chịu lỗi! - Cụm 5 nodes: Cho phép chết tối đa nodes (Quorum ).
💡 Thiết Kế Giao Dịch Bù Trừ Trong Saga Bắt Buộc Phải Có Tính Idempotent
- Trong mạng phân tán, tin nhắn kích hoạt lệnh bù trừ (
RefundPaymenthoặcRestockInventory) có thể bị gửi lặp lại nhiều lần do cơ chế retry mạng. - Quy tắc sống còn: Mọi hàm bồi hoàn (Compensating Function) bắt buộc phải có tính Lũy đẳng (Idempotent) và có khả năng xử lý sự kiện đến ngoài thứ tự (Out-of-Order Execution):
- Nếu lệnh bù trừ (
CancelOrder) vô tình đến trước lệnh khởi tạo (CreateOrder), hệ thống phải ghi nhận trạng thái hủy trước để khi lệnh tạo đơn đến sau, nó sẽ tự động bị từ chối ngay lập tức!
- Nếu lệnh bù trừ (
5. Góc Ôn Luyện Phỏng Vấn (Interview Corner)
❓ Câu hỏi 1: Giải thích cơ chế Bầu cử Trưởng nhóm (Leader Election) trong thuật toán Raft. Randomized Election Timeout giúp giải quyết vấn đề gì và tại sao Raft không bao giờ xảy ra hiện tượng Split-Brain (hai Leader cùng tồn tại trong một nhiệm kỳ)?
- Gợi ý trả lời:
- Cơ chế hoạt động:
- Khi Leader đang hoạt động, nó định kỳ gửi các gói tin Heartbeat (
AppendEntries) rỗng để duy trì quyền lực. - Nếu một Follower không nhận được heartbeat trong khoảng thời gian Election Timeout, nó giả định Leader đã chết, tự tăng Term lên , chuyển thành Candidate và gửi
RequestVote RPCkêu gọi bầu cử. - Node nhận được đa số phiếu tuyệt đối () sẽ đắc cử Leader.
- Khi Leader đang hoạt động, nó định kỳ gửi các gói tin Heartbeat (
- Vai trò của Randomized Election Timeout ():
- Nếu tất cả các Follower có cùng một thời gian timeout cố định, khi Leader chết, toàn bộ các Followers sẽ đồng loạt chuyển thành Candidate tại cùng một mili-giây.
- Mỗi node sẽ tự bầu cho chính nó, dẫn đến hiện tượng Phiếu bầu bị phân tán (Split Vote) và không ai giành được đa số Bầu cử thất bại liên tục.
- Việc chọn thời gian timeout ngẫu nhiên đảm bảo thường chỉ có duy nhất 1 node bị timeout trước, nhanh chóng phát lệnh xin phiếu và đắc cử trước khi các node khác kịp timeout.
- Tại sao không thể có Split-Brain trong cùng một Term:
- Để đắc cử, Candidate bắt buộc phải thu thập được phiếu bầu từ một Đa số chặt chẽ (Strict Majority): .
- Mỗi node trong Raft chỉ được phép bỏ đúng 1 phiếu duy nhất trong mỗi Term theo nguyên tắc ai đến trước phục vụ trước.
- Về mặt toán học, hai tập hợp đa số bất kỳ của một tập phần tử bắt buộc phải có ít nhất 1 phần tử giao nhau:
- Phần tử giao nhau này không thể vừa bỏ phiếu cho Leader 1 vừa bỏ phiếu cho Leader 2 trong cùng một Term Về mặt toán học, không thể tồn tại 2 Leader trong cùng 1 Term!
- Cơ chế hoạt động:
❓ Câu hỏi 2: Phân tích chi tiết điểm yếu "Khóa chết" (Blocking Problem) của giao thức Two-Phase Commit (2PC). Kịch bản nào khiến các node tham gia bị treo vô thời hạn và cách ngành công nghiệp giải quyết vấn đề này trong thực tế là gì?
- Gợi ý trả lời:
- Kịch bản Khóa chết của 2PC:
- Giai đoạn 1 kết thúc thành công: Tất cả các Participant đều đã ghi log, khóa tài nguyên dữ liệu và gửi thông điệp
VOTE_COMMITvề cho Coordinator. - Coordinator nhận đủ phiếu, ghi lệnh
GLOBAL_COMMITvào đĩa của mình và chuẩn bị gửi đi. - Ngay tại khoảnh khắc này, Coordinator bị sập nguồn hoàn toàn (hoặc đứt cáp mạng toàn bộ)!
- Tình thế bế tắc của các Participants:
- Các Participant không thể tự ý
Commit: Vì họ không biết liệu có Participant nào khác đã bỏ phiếuABORThay không. - Các Participant cũng không thể tự ý
Rollback: Vì có thể Coordinator đã kịp gửi lệnhGLOBAL_COMMITcho một node khác trước khi sập. - Toàn bộ các Participant rơi vào trạng thái lấp lửng (In-Doubt State), bắt buộc phải giữ chặt các ổ khóa tài nguyên (Locks) cho đến khi Coordinator được sửa chữa và khởi động lại. Mọi giao dịch khác của người dùng đụng vào các dòng dữ liệu đó đều bị treo hoàn toàn.
- Các Participant không thể tự ý
- Giai đoạn 1 kết thúc thành công: Tất cả các Participant đều đã ghi log, khóa tài nguyên dữ liệu và gửi thông điệp
- Cách giải quyết trong thực tế:
- Giải pháp 1 (Bỏ khóa đồng bộ - Dùng Saga Pattern): Trong các hệ thống phân tán hiện đại, từ bỏ hoàn toàn 2PC để chuyển sang Saga: Mỗi service chỉ commit cục bộ trên DB của mình, giải phóng khóa ngay lập tức và dựa vào giao dịch bù trừ nếu có lỗi.
- Giải pháp 2 (Áp dụng Consensus vào 2PC - Google Spanner / TiDB): Thay vì dùng một Coordinator đơn lẻ (Single Point of Failure), Coordinator và từng nhóm Participant được biến thành một cụm Raft / Paxos đa node. Dù có 1 máy chủ coordinator bị chết, cụm Raft sẽ tự bầu Coordinator mới trong vài trăm mili-giây để tiếp tục hoàn tất 2PC mà không bị treo hệ thống.
- Kịch bản Khóa chết của 2PC:
❓ Câu hỏi 3: Khi thiết kế hệ thống thanh toán và xử lý đơn hàng theo kiến trúc Saga Pattern, làm thế nào để xử lý vấn đề "Mất tính cô lập" (Lack of Isolation) khi người dùng khác có thể nhìn thấy dữ liệu trung gian chưa hoàn tất?
- Gợi ý trả lời:
- Bản chất vấn đề:
- Khác với giao dịch ACID truyền thống (đảm bảo tính Cô lập - Isolation: không ai nhìn thấy dữ liệu dở dang cho đến khi commit), Saga giải phóng khóa ngay sau mỗi giao dịch cục bộ.
- Hiện tượng: Khách hàng đang đặt phòng khách sạn (đã giữ phòng ở bước 1), một khách hàng khác vào xem thấy phòng đã hết. Nhưng sau đó khách thanh toán thất bại ở bước 2 Phòng được hoàn lại cho kho. Khách đã bỏ lỡ cơ hội mua phòng một cách vô lý!
- 3 Chiến lược xử lý chuẩn công nghiệp (Saga Countermeasures):
- Sử dụng trạng thái ngữ nghĩa treo (Semantic Locking / Pending State):
- Thay vì đổi thẳng trạng thái thành
COMPLETED, bản ghi được gán trạng thái trung gianPENDING_PAYMENT. - Các giao dịch khác đọc vào sẽ hiểu rằng đơn hàng này đang trong tiến trình xử lý và áp dụng logic phù hợp (ví dụ: hiển thị "Đang có người giữ chỗ trong 5 phút").
- Thay vì đổi thẳng trạng thái thành
- Thao tác có tính hoán vị (Commutative Updates):
- Thiết kế các bước cập nhật sao cho thứ tự thực hiện không làm thay đổi kết quả cuối cùng (ví dụ: các thao tác cộng dồn số dư tài khoản hoặc cộng trừ điểm thưởng).
- Kiểm tra phiên bản đọc lại (Reread Proof / Optimistic Lock):
- Trước khi thực hiện lệnh bồi hoàn, kiểm tra lại xem dữ liệu có bị một giao dịch khác can thiệp ghi đè hay chưa để tránh hiện tượng mất dữ liệu cập nhật (Lost Updates).
- Sử dụng trạng thái ngữ nghĩa treo (Semantic Locking / Pending State):
- Bản chất vấn đề:
6. Tóm Tắt Ghi Nhớ Nhanh (Key Takeaways)
- Định lý FLP: Trong mạng phân tán bất đồng bộ, không thể có thuật toán đồng thuận vừa Tuyệt đối Đúng (Safety) vừa Không bao giờ treo (Liveness) khi có node crash.
- Raft Consensus là chuẩn mực hiện đại (Kafka KRaft, etcd) chia đồng thuận thành: Leader Election, Log Replication và Safety dựa trên nguyên tắc Đa số (Strict Majority Quorum).
- Luôn cấu hình số lượng node trong cụm đồng thuận là Số Lẻ () để tối ưu hóa khả năng chịu lỗi.
- Two-Phase Commit (2PC) mang lại Strong Consistency nhưng là giao thức Khóa chặn (Blocking) dễ gây tê liệt hệ thống khi Coordinator sập.
- Saga Pattern (Orchestration & Choreography) là tiêu chuẩn vàng cho Microservices: Thay thế khóa phân tán bằng chuỗi Giao dịch cục bộ + Bút toán bù trừ (Compensating Transactions) có tính lũy đẳng (Idempotency).