[Tech Blog #35 | AI & GenAI] Đánh Giá Hệ Thống RAG & LLM: Bộ Ba Thước Đo RAG Triad & Kỹ Thuật LLM-as-a-Judge
1. Đặt vấn đề: "Làm sao biết con Chatbot của bạn đã đủ tốt để ra mắt khách hàng?"
Ở các bài viết trước, chúng ta đã xây dựng RAG cơ bản ([Tech Blog #11]), nâng cấp RAG với Reranking ([Tech Blog #31]), và làm chủ Function Calling ([Tech Blog #15]).
Thế nhưng, khi bạn trình bày sản phẩm trước Giám đốc Kỹ thuật (CTO), câu hỏi đầu tiên bạn nhận được sẽ luôn là:
"Hệ thống RAG này đạt độ chính xác bao nhiêu phần trăm? Tỷ lệ ảo giác (Hallucination) là bao nhiêu? Dựa vào đâu để em dám khẳng định bản nâng cấp hôm nay tốt hơn bản ngày hôm qua?"
Nếu bạn trả lời: "Dạ em tự hỏi thử 10 câu thấy nó trả lời mượt mà lắm anh", thì sản phẩm của bạn sẽ bị từ chối đưa lên Production ngay lập tức.
Bạn không thể kiểm thử một hệ thống AI bằng cảm tính, và bạn cũng không thể thuê hàng chục nhân viên ngồi đọc và chấm điểm bằng tay 10.000 câu hỏi mỗi tuần.
Để tự động hóa việc kiểm thử và đo lường chất lượng của các ứng dụng GenAI, ngành công nghiệp AI đã chuẩn hóa một khung đánh giá kinh điển: Bộ ba thước đo RAG Triad kết hợp cùng phương pháp LLM-as-a-Judge (Dùng AI làm trọng tài).
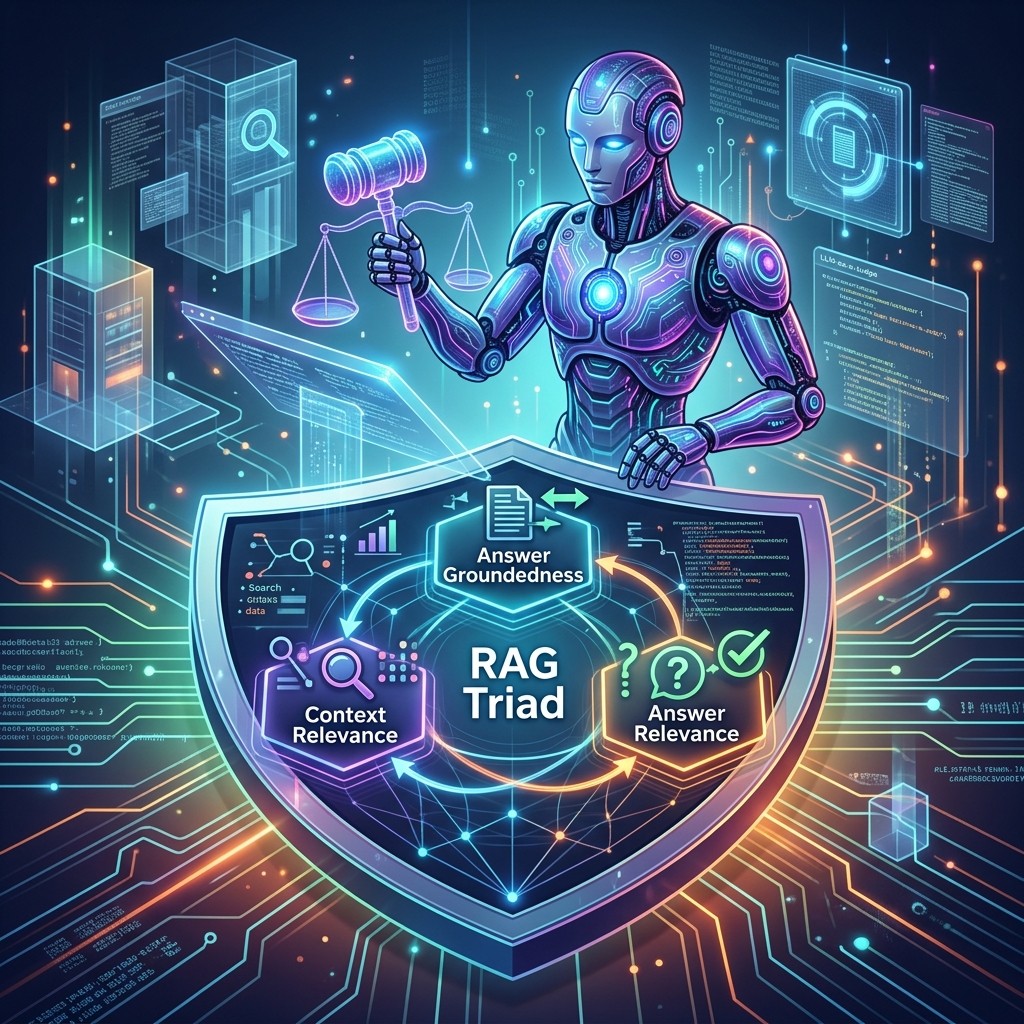
2. Giải mã bộ ba thước đo RAG Triad (The 3 Pillars of RAG Evaluation)
Một câu trả lời tệ hại của RAG có thể bắt nguồn từ 2 nguyên nhân: Hoặc là do bước tìm kiếm tài liệu (Retrieval) bị sai, hoặc là do bước tổng hợp của LLM (Generation) bị ảo giác.
Bộ ba thước đo RAG Triad bóc tách độc lập từng mắt xích:
                      [CÂU HỎI CỦA NGƯỜI DÙNG]
                             /        \
                            /          \
   1. Context Relevance    /            \    3. Answer Relevance
 (Tài liệu có đúng trọng tâm?)            \ (Câu trả lời có trúng câu hỏi?)
                          /                \
                         ▼                  ▼
                [TÀI LIỆU TRUY XUẤT] ────► [CÂU TRẢ LỜI CỦA LLM]
                         (Context)       ▲   (Generated Answer)
                                         │
                                 2. Groundedness / Faithfulness
                               (Câu trả lời có bám sát 100% tài liệu,
                                hay tự bịa thêm thông tin ngoài?)
2.1. Thước đo 1: Context Relevance (Độ liên quan của ngữ cảnh)
- Kiểm tra mắt xích: Bước Retrieval (Vector Search & Reranking).
- Câu hỏi cốt lõi: "Trong các đoạn văn bản mà hệ thống nhặt ra từ database, có thực sự chứa câu trả lời cho câu hỏi của người dùng không, hay toàn là thông tin rác?"
- Thang điểm: Từ 0.0 đến 1.0. Điểm thấp Cần cải thiện bước Chunking ([Tech Blog #31]) hoặc đổi mô hình Embedding ([Tech Blog #07]).
2.2. Thước đo 2: Groundedness / Faithfulness (Tính trung thực / Không ảo giác)
- Kiểm tra mắt xích: Bước Generation (LLM).
- Câu hỏi cốt lõi: "Mọi thông tin trong câu trả lời cuối cùng có được suy ra trực tiếp 100% từ tài liệu cung cấp không? Mô hình có tự bịa thêm số liệu nào ngoài tài liệu không?"
- Ý nghĩa: Đây là chỉ số quan trọng nhất để đo lường tỷ lệ ảo giác (Hallucination Rate). Một câu trả lời đạt Faithfulness = 1.0 nghĩa là không có bất kỳ chi tiết bịa đặt nào.
2.3. Thước đo 3: Answer Relevance (Độ sát nghĩa của câu trả lời)
- Kiểm tra mắt xích: Sự tương thích giữa Input và Output.
- Câu hỏi cốt lõi: "Câu trả lời có thực sự giải quyết đúng điều mà người dùng đang hỏi không, hay lại trả lời vòng vo tam quốc?"
3. Kỹ thuật LLM-as-a-Judge: Dùng AI làm ban giám khảo
Thay vì tốn hàng tuần lễ để con người chấm điểm thủ công:
Chúng ta sử dụng một mô hình LLM cao cấp hơn (ví dụ: GPT-4o hoặc Claude 3.5 Sonnet) đóng vai trò là "Vị thẩm phán" (Judge).
Chúng ta nạp vào: (1) Câu hỏi, (2) Tài liệu ngữ cảnh, (3) Câu trả lời của hệ thống, kèm theo một Tiêu chí chấm điểm chi tiết (Rubric) và ép vị thẩm phán trả về điểm số từ 1 đến 5 kèm theo lời giải thích lý do cụ thể.
4. Bảng tổng hợp các thước đo đánh giá RAG
| Thước đo | Thành phần bị đánh giá | Ý nghĩa kinh doanh thực tế | Cách khắc phục nếu điểm thấp |
|---|---|---|---|
| Context Relevance | (Query, Context) | Tìm đúng đoạn văn bản cần tìm, loại bỏ bớt tài liệu rác làm loãng prompt. | Tối ưu hóa Chunk size, bổ sung từ khóa (Hybrid Search), dùng Cross-Encoder Reranker. |
| Faithfulness | (Context, Answer) | Triệt tiêu ảo giác: Đảm bảo câu trả lời bám sát quy chế công ty, không tự bịa đặt. | Hạ nhiệt độ temperature = 0.0, siết chặt System Prompt ([Tech Blog #19]), phạt nặng suy diễn. |
| Answer Relevance | (Query, Answer) | Trả lời đúng trọng tâm câu hỏi của khách hàng, ngắn gọn, dễ hiểu. | Cải thiện prompt hướng dẫn định dạng, yêu cầu trả lời trực diện câu hỏi. |
5. Thực hành thực chiến: Tự xây dựng "Vị Thẩm Phán AI" bằng Python
Đoạn mã Python dưới đây sử dụng kỹ thuật LLM-as-a-Judge với Structured JSON Output ([Tech Blog #03]) để tự động chấm điểm độ trung thực (Faithfulness) của một câu trả lời RAG:
import os
import json
from openai import OpenAI

client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY", "your-api-key-here"))

# ==============================================================================
# BƯỚC 1: XÂY DỰNG PROMPT CHẤM ĐIỂM CHUẨN MỰC CHO "VỊ THẨM PHÁN" (RUBRIC)
# ==============================================================================
EVALUATOR_SYSTEM_PROMPT = """
Bạn là một chuyên gia kiểm định chất lượng AI độc lập và vô cùng khắt khe.
Nhiệm vụ của bạn là đánh giá tính trung thực (Faithfulness / Groundedness) của [CÂU TRẢ LỜI] dựa trên [TÀI LIỆU CHỨNG CỨ].

Định nghĩa Faithfulness:
- Mọi dữ kiện, số liệu, mốc thời gian trong câu trả lời phải được tìm thấy trực tiếp trong tài liệu chứng cứ.
- Nếu câu trả lời chứa bất kỳ thông tin nào tự suy diễn, bịa đặt hoặc không có trong tài liệu, phải trừ điểm rất nặng.

Thang điểm từ 1 đến 5:
- 5/5: Hoàn hảo. 100% thông tin đều có dẫn chứng rõ ràng từ tài liệu.
- 3/5: Một phần đúng, nhưng có một vài chi tiết nhỏ bị suy đoán không có căn cứ.
- 1/5: Ảo giác nghiêm trọng (Hallucination). Câu trả lời mâu thuẫn hoàn toàn hoặc tự bịa ra thông tin.

Bạn BẮT BUỘC phải trả về kết quả dưới định dạng JSON duy nhất gồm 3 trường:
{
    "score": (số nguyên từ 1 đến 5),
    "reasoning": (giải thích ngắn gọn tại sao chấm điểm này),
    "has_hallucination": (true hoặc false)
}
"""

def evaluate_faithfulness(question: str, context: str, answer: str) -> dict:
    """Hàm gửi dữ liệu lên LLM Judge để tự động chấm điểm tính trung thực."""

    user_eval_prompt = f"""
    [CÂU HỎI CỦA NGƯỜI DÙNG]:
    {question}

    [TÀI LIỆU CHỨNG CỨ (CONTEXT)]:
    {context}

    [CÂU TRẢ LỜI CỦA HỆ THỐNG RAG]:
    {answer}
    """

    response = client.chat.completions.create(
        model="gpt-4o-mini", # Trong thực tế có thể dùng gpt-4o để chấm điểm khách quan nhất
        messages=[
            {"role": "system", "content": EVALUATOR_SYSTEM_PROMPT},
            {"role": "user", "content": user_eval_prompt}
        ],
        temperature=0.0, # Đặt bằng 0 để kết quả chấm điểm luôn nhất quán
        response_format={"type": "json_object"}
    )

    return json.loads(response.choices[0].message.content)

# ==============================================================================
# BƯỚC 2: CHẠY THỬ NGHIỆM ĐÁNH GIÁ 2 KỊCH BẢN THỰC TẾ
# ==============================================================================
if __name__ == "__main__":
    context_doc = "Chính sách công ty quy định: Nhân viên được hỗ trợ 100% học phí thi chứng chỉ AWS/GCP nếu đạt điểm đỗ và cam kết làm việc tối thiểu 1 năm."
    user_q = "Tôi thi chứng chỉ AWS có được công ty hỗ trợ tiền không?"

    # Kịch bản A: Câu trả lời chuẩn mực, trung thực 100%
    good_answer = "Có, công ty sẽ hỗ trợ 100% học phí thi chứng chỉ AWS nếu bạn thi đỗ và có cam kết làm việc tối thiểu 1 năm tại công ty."

    # Kịch bản B: Câu trả lời bị ẢO GIÁC (Tự bịa thêm số tiền 5 triệu)
    hallucinated_answer = "Có, công ty sẽ hỗ trợ tối đa 5.000.000 VNĐ cho mỗi chứng chỉ AWS và bạn có thể thi bao nhiêu lần tùy thích."

    print(">>> 1. ĐÁNH GIÁ CÂU TRẢ LỜI CHUẨN MỰC (KỊCH BẢN A):")
    result_a = evaluate_faithfulness(user_q, context_doc, good_answer)
    print(json.dumps(result_a, indent=4, ensure_ascii=False))

    print("\n>>> 2. ĐÁNH GIÁ CÂU TRẢ LỜI BỊ ẢO GIÁC (KỊCH BẢN B):")
    result_b = evaluate_faithfulness(user_q, context_doc, hallucinated_answer)
    print(json.dumps(result_b, indent=4, ensure_ascii=False))
6. Câu hỏi phỏng vấn thực tế (Interview Q&A)
Câu 1 (Mức độ: Entry / Junior)
Câu hỏi: "RAG Triad là gì? Tại sao chỉ kiểm tra câu trả lời cuối cùng (Output) là chưa đủ để đánh giá một hệ thống RAG?"
Gợi ý trả lời:
*"RAG Triad là khung đánh giá gồm 3 trụ cột: Context Relevance (Độ liên quan của ngữ cảnh tìm được), Groundedness/Faithfulness (Tính trung thực, không bịa đặt), và Answer Relevance (Độ sát nghĩa với câu hỏi).
Nếu chỉ kiểm tra câu trả lời cuối cùng, chúng ta sẽ không biết lỗi xuất phát từ đâu khi hệ thống trả lời sai:
- Nếu câu trả lời sai do bước tìm kiếm nhặt về toàn văn bản rác, thì đó là lỗi của tầng Retrieval (cần sửa thuật toán Chunking hoặc Embedding).
- Nếu văn bản tìm về đã rất đầy đủ nhưng LLM vẫn trả lời sai lệch, thì đó là lỗi của tầng Generation (cần sửa System Prompt hoặc đổi mô hình thông minh hơn).
RAG Triad giúp bóc tách và định vị chính xác mắt xích nào đang bị hỏng trong quy trình để tối ưu hóa có mục tiêu."*
Câu 2 (Mức độ: Junior / Mid-level)
Câu hỏi: "Phương pháp LLM-as-a-Judge có những thiên vị (Biases) tiềm ẩn nào và làm thế nào để hạn chế chúng khi đánh giá mô hình?"
Gợi ý trả lời:
*"LLM-as-a-Judge rất mạnh nhưng có 3 thiên vị kinh điển:
- Position Bias (Thiên vị vị trí): Khi so sánh 2 câu trả lời A và B, mô hình thường có xu hướng thiên vị câu trả lời đứng ở vị trí đầu tiên (hoặc cuối cùng). Khắc phục: Đảo ngược vị trí của A và B rồi lấy điểm trung bình của cả 2 lần chấm.
- Verbosity Bias (Thiên vị độ dài): Mô hình giám khảo thường ngầm chấm điểm cao hơn cho các câu trả lời dài dòng, hoa mỹ dù nội dung không đúng trọng tâm. Khắc phục: Nêu rõ trong Rubric: Phạt điểm nếu trả lời dài dòng và ưu tiên sự súc tích.
- Self-Enhancement Bias (Thiên vị 'gà nhà'): Mô hình của OpenAI thường có xu hướng chấm điểm cao hơn cho các văn bản do chính OpenAI sinh ra so với Claude hay Gemini. Khắc phục: Sử dụng nhiều mô hình giám khảo khác nhau (Ensemble of Judges) hoặc dùng các mô hình độc lập chuyên biệt cho việc đánh giá (như Prometheus, Llama-3-Judge)."*
7. Key Takeaways (Ghi nhớ nhanh)
- Không đưa AI lên Production dựa trên cảm tính: Mọi thay đổi về code hay prompt đều phải được đo lường bằng số liệu định lượng cụ thể.
- Khắc cốt ghi tâm RAG Triad:
- Context Relevance: Tìm có đúng tài liệu không?
- Faithfulness: Có bịa đặt thông tin ngoài tài liệu không? (Đo lường ảo giác).
- Answer Relevance: Có trả lời đúng trọng tâm câu hỏi không?
- LLM-as-a-Judge tự động hóa quy trình kiểm thử: Dùng mô hình mạnh chấm điểm mô hình nhẹ theo thang điểm và tiêu chí (Rubric) nghiêm ngặt dạng JSON.
- Tích hợp vào CI/CD Pipeline: Tự động chạy bộ test 100 câu hỏi chuẩn mỗi khi ai đó chỉnh sửa prompt; nếu điểm Faithfulness bị tụt dưới 0.95 thì chặn không cho deploy lên Production!